客户案例
Prime Intellect 在 OpenRouter 上的用量增长至 100 倍,每 token 成本降低了 60%
Prime Intellect 构建开放的前沿模型,以及用于训练、部署和改进这些模型的技术栈。过去一年,其在 OpenRouter 上的月度 token 用量从 110 亿增长至超过 1 万亿,同时每 token 的综合成本下降了约 60%。
以单位成本的智能水平为核心
Prime Intellect 构建开放的前沿模型,以及用于训练、部署和持续改进这些模型的基础设施。它押注 AI 的未来将是多模型的。Prime Intellect 的首席执行官兼联合创始人 Vincent Weisser 表示:“我们相信,未来将有无数模型针对不同用例持续自我改进。”
“我们希望确保未来不会只有一家公司打造的一个全能模型。”
客户来到 Prime Intellect,是为了用自己的数据对模型进行后训练,并在 Prime 平台上提供模型服务。在后训练之前,他们需要知道该从哪个模型开始。Vincent 表示:“客户想看到的是每花一美元能提供最多智能的模型。”“而这确实每周、每月甚至每天都在变化,取决于新模型何时发布。”
要为客户以及 Prime Intellect 自身的研究回答这个问题,就意味着需要在新模型发布后立即进行评估。Prime Intellect 通过 OpenRouter 运行这些评估。它利用评估结果,根据价格和性能选择模型,并将每项工作负载发送到能够处理它的最便宜的模型。
更多模型、更多支出、更多集成
“我们非常重视评估。我们一直在评估模型,”Prime Intellect 应用研究负责人 Will Brown 说。他的团队会测试可能用于后训练的模型,或其输出可能用作训练数据的模型,因此新模型一经发布就需要融入现有工作流。
负责 Prime Intellect 推理开发的 Stu Cao 会收到这些请求。“我每天都会不断收到研究团队的请求:‘嘿,这个模型可用了吗?这个模型可用了吗?’”他说。
在使用 OpenRouter 之前,每次答应这样的请求都意味着要连接另一家提供商的 API,并设置另一套计费方案。每家提供商都有自己的端点、API 密钥、身份验证和缓存控制。
“您实际上是在管理大量不同的端点,还有不同的 API 密钥。这很让人头疼。”
每个模型的可靠性也完全取决于团队用于访问该模型的提供商。如果该提供商宕机,发往该模型的所有请求都会失败,而且团队没有其他地方可以发送这些请求。“您实际上是在应对大量单点故障,”Stu 说。
与此同时,支出也在攀升。“我们看到各团队的内部推理支出大幅增加,”Vincent 说。
为何选择 OpenRouter
Prime Intellect 希望将工程时间投入评估框架和后训练,而不是耗费在访问 AI 模型的复杂运维工作上。“与你们合作,比我们自己集成数百家提供商的数千个模型容易得多,”Vincent 说。
团队将模型访问迁移到了 OpenRouter。
“现在只需一个端点、一个 API 密钥。这让我们的软件栈更加简洁,也让我们能够专注于上层技术栈。”
Will 表示,研究人员不再需要考虑模型托管在哪里。“我更愿意关注模型本身、它能做什么、速度有多快、效率有多高,而不是它来自哪个底层来源,”他说。“能够将这一切抽象掉,作用非常强大。”
成效
用量增至 100 倍,每 token 成本降低约 60%
Prime Intellect 在 OpenRouter 上的每月 token 用量从 2025 年 11 月的 110 亿增长至 2026 年 9 月的逾 1 万亿。在此期间,按综合成本计算,其每百万 token 消耗的额度从约 $1.23 降至约 $0.46。
Vincent 将这些成效很大程度上归功于模型选择,称其为“如今在数百个模型的海洋中,最大的突破口之一”。
“关键其实在于,如何确保始终将请求路由到最好且最便宜的模型。”
提供商选择也起到了帮助作用。OpenRouter 向 Stu 提供各个模型的流量、吞吐量、正常运行时间和提供商数据,他则用这些数据优化路由。“OpenRouter 其实为我提供了每个模型极其详尽的分析,包括流量情况以及有哪些优化机会,”他说。“我们会利用这些反馈,例如设置合适的提供商顺序。而这确实显著提高了我们的效率,降低了我们的成本。”
提供商故障不再影响用户
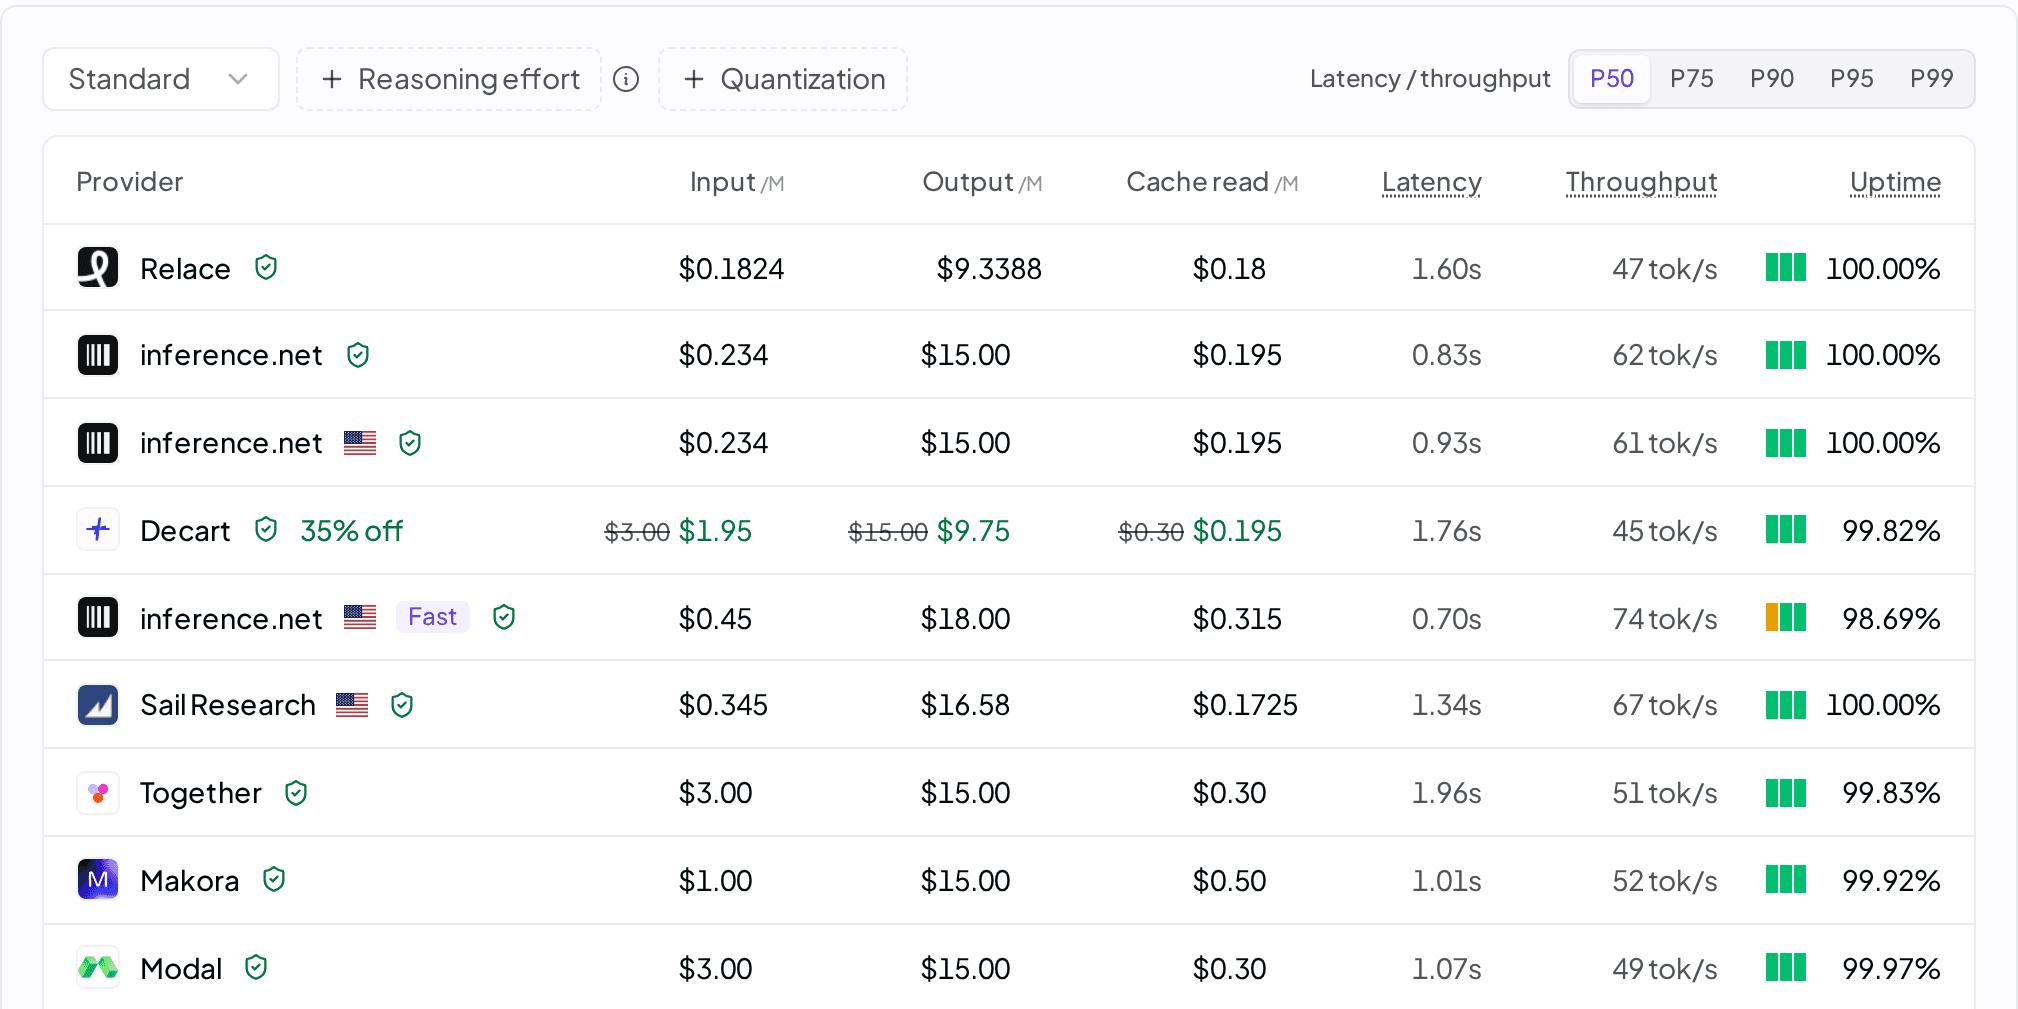
同一模型在不同提供商上的表现可能大不相同。OpenRouter 向 Stu 展示了为某个模型提供服务的每家提供商的正常运行时间和吞吐量。他说:“这确实让我在决定选择哪家提供商时有了非常清晰的认识。”
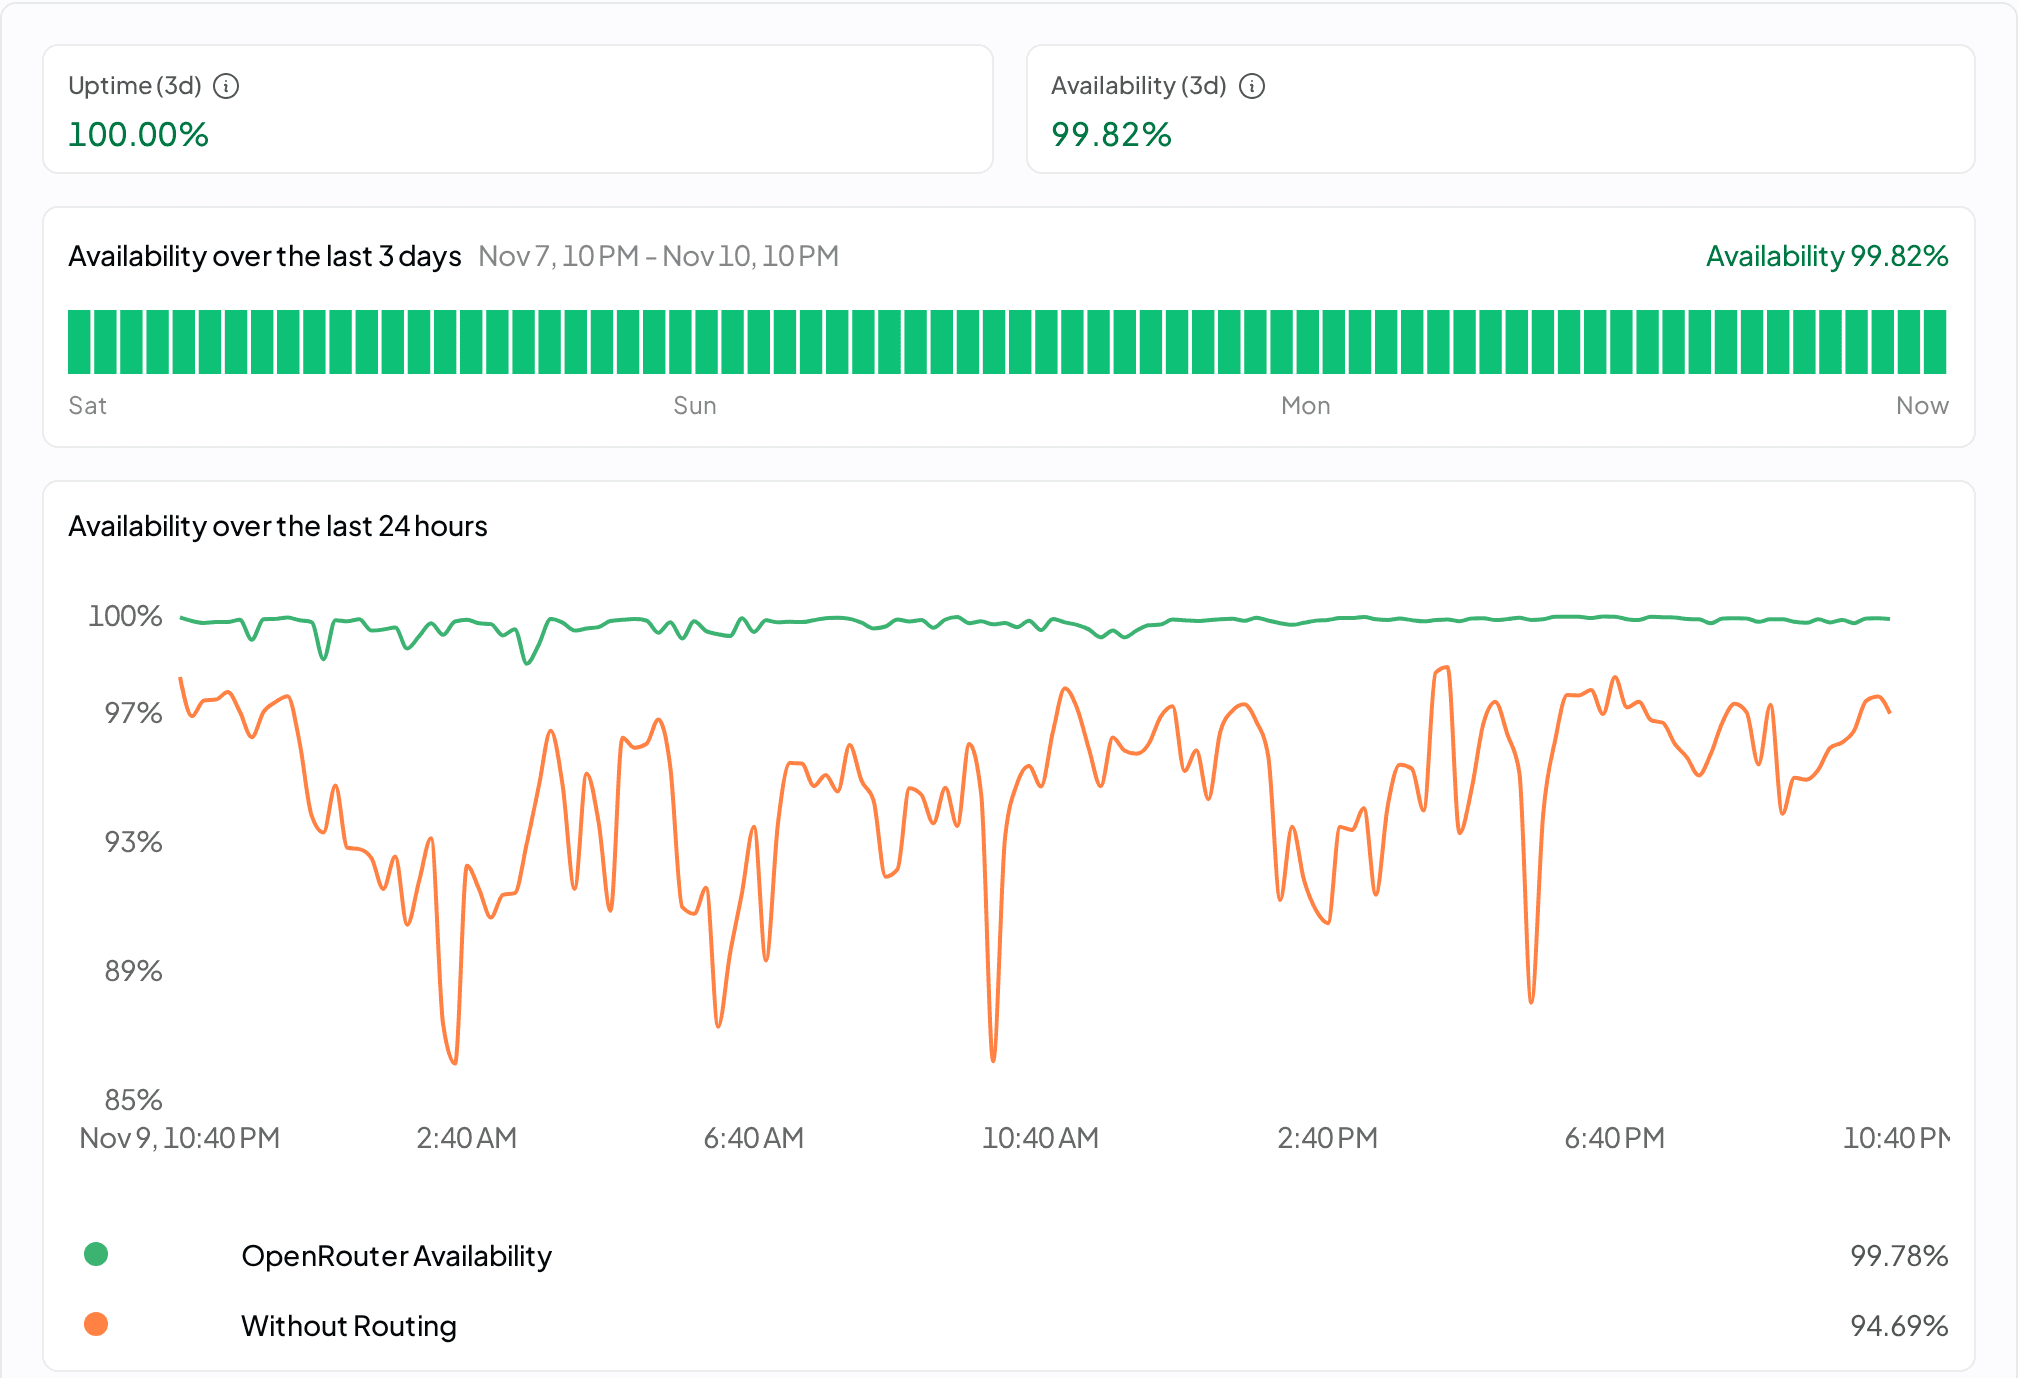
对于每个模型,他都会将吞吐量和正常运行时间最佳的提供商排在首位。他说:“如果这家提供商发生故障,OpenRouter 就会自动切换到列表中的下一家提供商。”“我们仍然在使用最喜欢的提供商,而且这种回退基本上不会影响我们的产品。”
在一个月内,Prime Intellect 约有 640,000 个请求在首次尝试的提供商处失败,随后由另一家提供商完成。Stu 说:“切换非常顺畅,我们这边几乎从未察觉到任何服务中断。”
新模型首日即可使用
新模型通过团队已在使用的 API 和身份验证方式接入。Stu 说:“只要有模型可用,我们就能立即使用。”Kimi K3 和 GLM 5.2 各自在 OpenRouter 上首次产生流量后不到一天,Prime Intellect 就已开始运行它们。被问及接入新模型需要多久时,Will 说:“这取决于输入模型名称需要多长时间。”
“OpenRouter 为 Prime Intellect 带来的最大变化就是速度。”
Stu 说:“作为一家初创公司,我们非常珍视速度。”“这让我们能够利用世界各地不断推出的模型持续创新。”
评估是日常工作的一部分
Will 的团队衡量各个模型在智能体编程和计算机使用等工作负载中的能力。开放模型是用于后训练或生成训练数据的候选模型。封闭模型则作为基准。“我们想了解自己与前沿水平还有多大差距,”Will 说。
这项工作依赖于以合理的成本访问每个模型。“要开展数据、评估和后训练方面的工作,以实惠的价格获得快速、可靠的 token 至关重要,”他说。
“OpenRouter 给我们带来的最大变化,就是让使用任何模型进行评估都变得简单且切实可行,”Will 说,“让评估自然而然地成为日常工作生命周期的一部分。”
作为提供商的 Prime Intellect
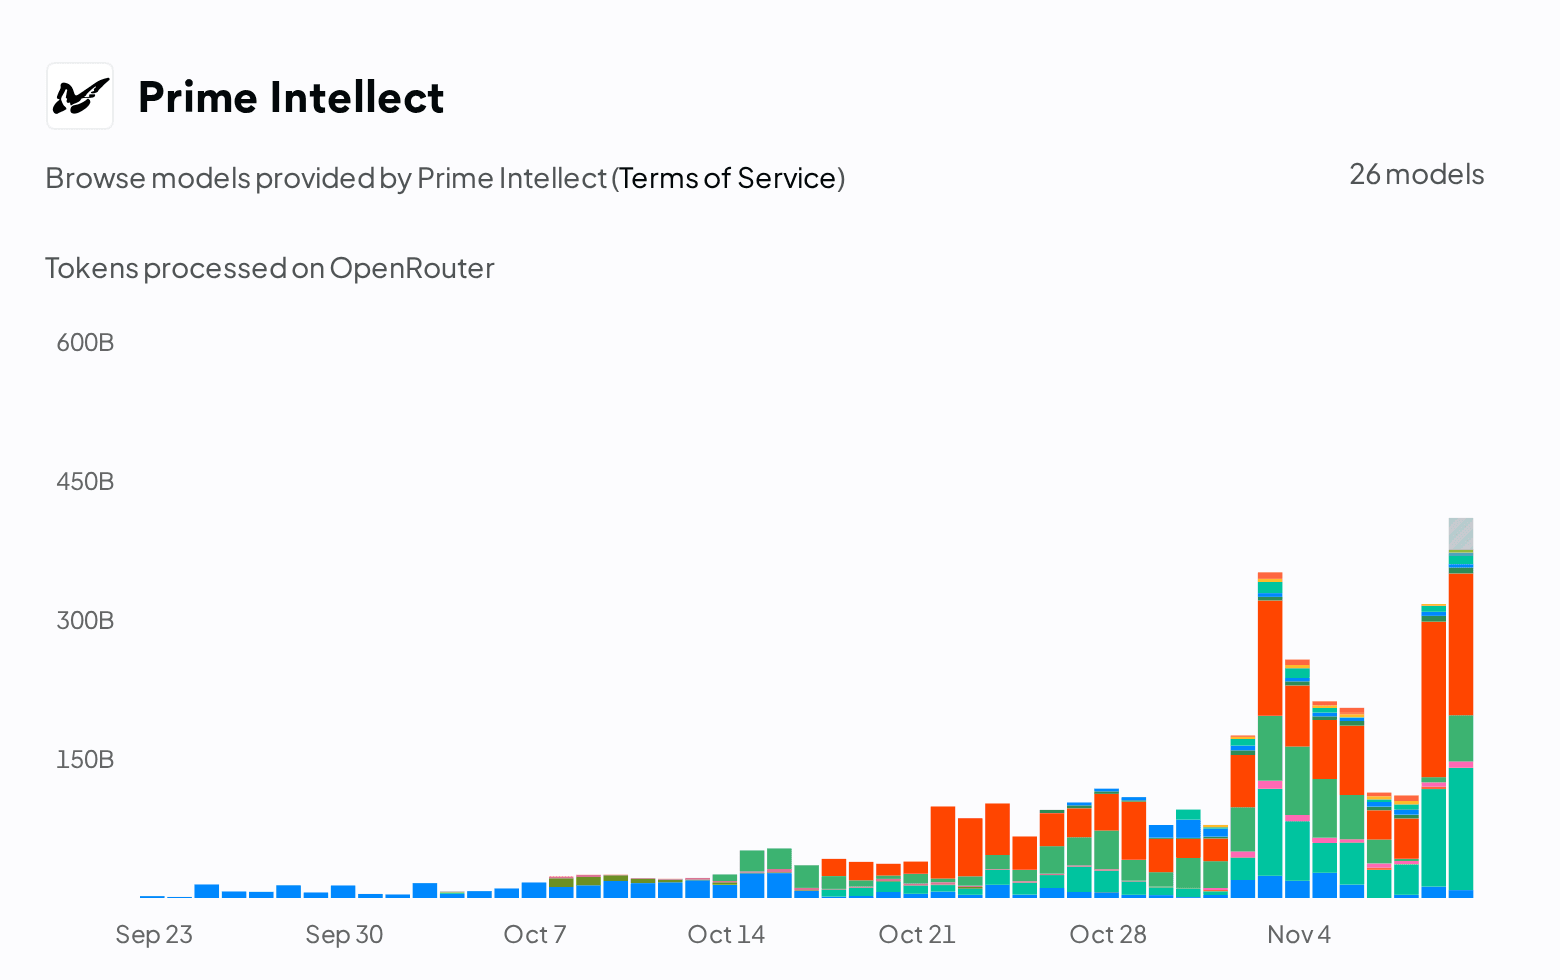
Prime Intellect 也在 OpenRouter 上销售推理服务,在一周内为近 48,000 个 OpenRouter 账户提供了 11 个模型的服务,处理了约 6700 亿个 token,每周 token 量较上个月增长至约 12 倍。Will 表示:“这是一个推理市场。”“在这里,我们既是消费者,也是生产者。”
这些流量让团队了解每个部署在生产环境中的表现。Will 说:“缓存效果好吗?延迟表现好吗?突发流量处理得好吗?”他们获得的经验会反馈到训练中。他说:“训练模型是为了部署,而部署又会影响下一个模型的训练方式。”
Stu 利用 OpenRouter 按模型提供的输入长度、推理和输出 token 以及吞吐量数据来设计 Prime Intellect 的推理服务集群。他说:“不存在一种万能的推理配置。”“我可以利用这些数据来优化我的推理服务栈。”
OpenRouter 上每家提供商的正常运行时间、吞吐量和价格都是公开的,因此用户可以将 Prime Intellect 与提供同一模型服务的其他提供商进行比较。Vincent 说:“如果您看到一家提供商的正常运行时间占比为 99.99%,而另一家只有 80%,您就会选择明显更可靠的那家。”“我认为,通过 OpenRouter 展示这些表现,我们也证明了自己在推理方面的实力。”
Will 从供需双方看到了同样的情况。他说:“无论是我们有能力托管模型,还是其他人有能力,我们都可以将这层差异抽象掉,而 OpenRouter 已经解决了这个问题。”
“这意味着多模型世界已经触手可及。”
更多客户案例
Sentry
Sentry 如何在不限制访问的情况下遏制失控的 AI 账单
Sentry 将内部 AI 使用迁移到 OpenRouter,停用了约 500 个提供商密钥,并在不限制模型选择的情况下,为失控账单设置了上限。
阅读故事Descript
Descript 如何让新模型接入不再占用工程排期
Descript 通过一次 OpenRouter 集成运行来自四家开发商的 13 个模型。他们如何将新模型评估时间从一周缩短到几个小时。
阅读故事Pax Historia
从大学宿舍到 2000 万轮游戏:Pax Historia 的架空历史游戏
两名大学新生如何打造出有史以来用户留存率最高的 AI 游戏之一——每日 3.5 万名玩家,仅上个月就通过 OpenRouter 发出了 487 万次请求。
阅读故事