Caso de cliente
Prime Intellect multiplicó por 100 su volumen en OpenRouter y redujo su costo por token un 60 %
Prime Intellect desarrolla modelos abiertos de vanguardia y la infraestructura para entrenarlos, ofrecerlos y mejorarlos. Durante el último año, su volumen mensual de tokens en OpenRouter pasó de 11.000 millones a más de 1 billón, mientras que su costo promedio combinado por token se redujo alrededor de un 60 %.
Diseñado para ofrecer inteligencia por dólar
Prime Intellect desarrolla modelos abiertos de vanguardia y la infraestructura para entrenarlos, desplegarlos y seguir mejorándolos. Apuesta por un futuro de la IA con múltiples modelos. «Creemos que habrá infinitos modelos que mejorarán continuamente por sí mismos para distintos casos de uso», afirma Vincent Weisser, director ejecutivo y cofundador de Prime Intellect.
«Queremos asegurarnos de que el futuro no dependa de un único modelo omnipotente de una sola empresa».
Los clientes acuden a Prime Intellect para realizar el posentrenamiento de un modelo con sus propios datos y servirlo en la plataforma de Prime. Antes del posentrenamiento, necesitan saber de qué modelo partir. «Lo que un cliente quiere ver es el modelo que le ofrece más inteligencia por dólar», afirma Vincent. «Y eso cambia literalmente cada semana, mes o día, según cuándo salgan nuevos modelos».
Responder a esa pregunta para los clientes y para la investigación de Prime Intellect implica evaluar los nuevos modelos en cuanto se publican. Prime Intellect ejecuta esas evaluaciones a través de OpenRouter. Usa los resultados para elegir modelos según su precio y rendimiento y enviar cada carga de trabajo al modelo más económico capaz de gestionarla.
Más modelos, más gasto, más integraciones
«Nos tomamos las evaluaciones muy en serio. Evaluamos modelos constantemente», afirma Will Brown, director de investigación aplicada de Prime Intellect. Su equipo prueba modelos a los que podría aplicar posentrenamiento o cuyas respuestas podría usar como datos de entrenamiento, por lo que cada nuevo modelo debe integrarse en sus flujos de trabajo existentes en cuanto se publica.
Stu Cao, que dirige el desarrollo de inferencia de Prime Intellect, recibe esas solicitudes. «Todos los días recibo solicitudes constantes del equipo de investigación: “Oye, ¿está disponible este modelo? ¿Está disponible este modelo?”», explica.
Antes de OpenRouter, cada sí implicaba conectar la API de otro proveedor y configurar otro plan de facturación. Cada proveedor tenía su propio endpoint, su propia clave de API y sus propios controles de autenticación y caché.
«Básicamente, hay que gestionar muchísimos endpoints distintos, además de distintas claves de API. Y eso es un quebradero de cabeza».
La fiabilidad de cada modelo también dependía por completo del proveedor que el equipo utilizara para acceder a él. Si ese proveedor dejaba de funcionar, todas las solicitudes a ese modelo fallaban y el equipo no tenía adónde más enviarlas. «Básicamente, hay que lidiar con muchos puntos únicos de fallo», afirma Stu.
Al mismo tiempo, el gasto aumentaba. «Hemos visto cómo el gasto interno en inferencia de nuestros equipos ha aumentado mucho», afirma Vincent.
Por qué OpenRouter
Prime Intellect quería dedicar el tiempo de ingeniería a los harnesses de evaluación y al posentrenamiento, en lugar de dedicarlo a la complejidad operativa del acceso a modelos de IA. «Es mucho más fácil colaborar con ustedes que tener que integrar por nuestra cuenta miles de modelos de cientos de proveedores», afirma Vincent.
El equipo trasladó su acceso a modelos a OpenRouter.
«Ahora es solo un endpoint y una clave de API. Esto simplifica mucho nuestra pila de software y nos permite centrarnos en las capas superiores».
Will afirma que los investigadores ya no tienen que pensar en dónde se aloja un modelo. «Prefiero pensar en el modelo, en lo que puede hacer, en su rapidez y su eficiencia, en lugar de pensar en la fuente subyacente de la que procede», afirma. «Poder abstraerse de todo eso es muy potente».
Los resultados
100 veces el volumen con un costo por tóken aproximadamente un 60 % menor
Los tókenes mensuales de Prime Intellect en OpenRouter pasaron de 11 mil millones en noviembre de 2025 a más de 1 billón en septiembre de 2026. En ese tiempo, su costo combinado por millón de tókenes bajó de unos 1,23 $ a unos 0,46 $.
Vincent da crédito a la elección de modelos por gran parte de ello, y la califica de «uno de los mayores avances que ahora permite este mar de cientos de modelos».
«En realidad, se trata de cómo garantizar que las solicitudes siempre se enruten al modelo que sea el mejor y el más barato».
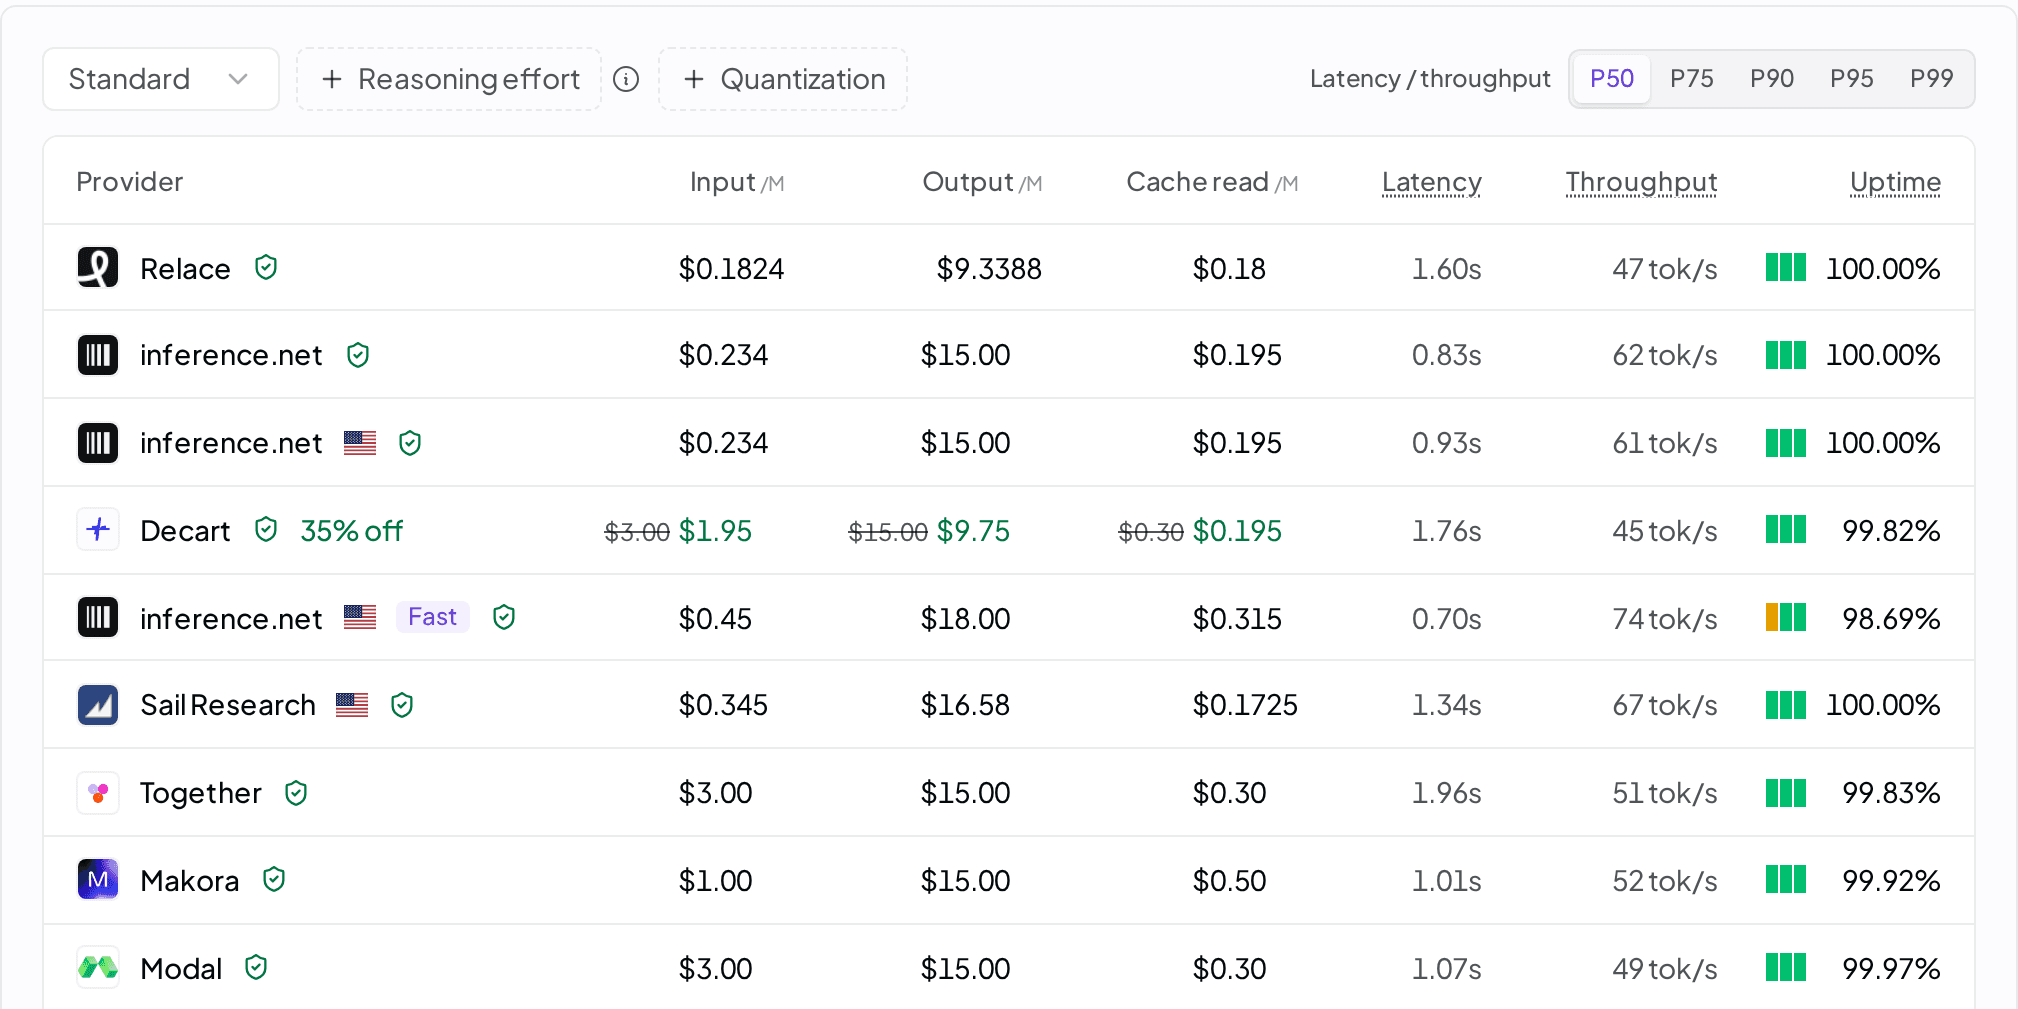
La elección de proveedores también ayudó. OpenRouter envía a Stu datos por modelo sobre el tráfico, el rendimiento, el tiempo de actividad y los proveedores, y él los usa para ajustar el enrutamiento. «OpenRouter me dio un desglose realmente muy detallado de cada modelo, de cómo es el tráfico y de qué oportunidades de optimización hay», dice. «Tomamos esos comentarios y, por ejemplo, establecemos el orden adecuado de los proveedores. Y eso mejoró considerablemente nuestra eficiencia y redujo nuestro costo».
Las interrupciones de los proveedores ya no afectan a los usuarios
El mismo modelo puede rendir de forma muy distinta de un proveedor a otro. OpenRouter muestra a Stu el tiempo de actividad y la capacidad de procesamiento de cada proveedor que ofrece un modelo. «Esto me dio una visión muy clara para determinar qué proveedor elegiría», afirma.
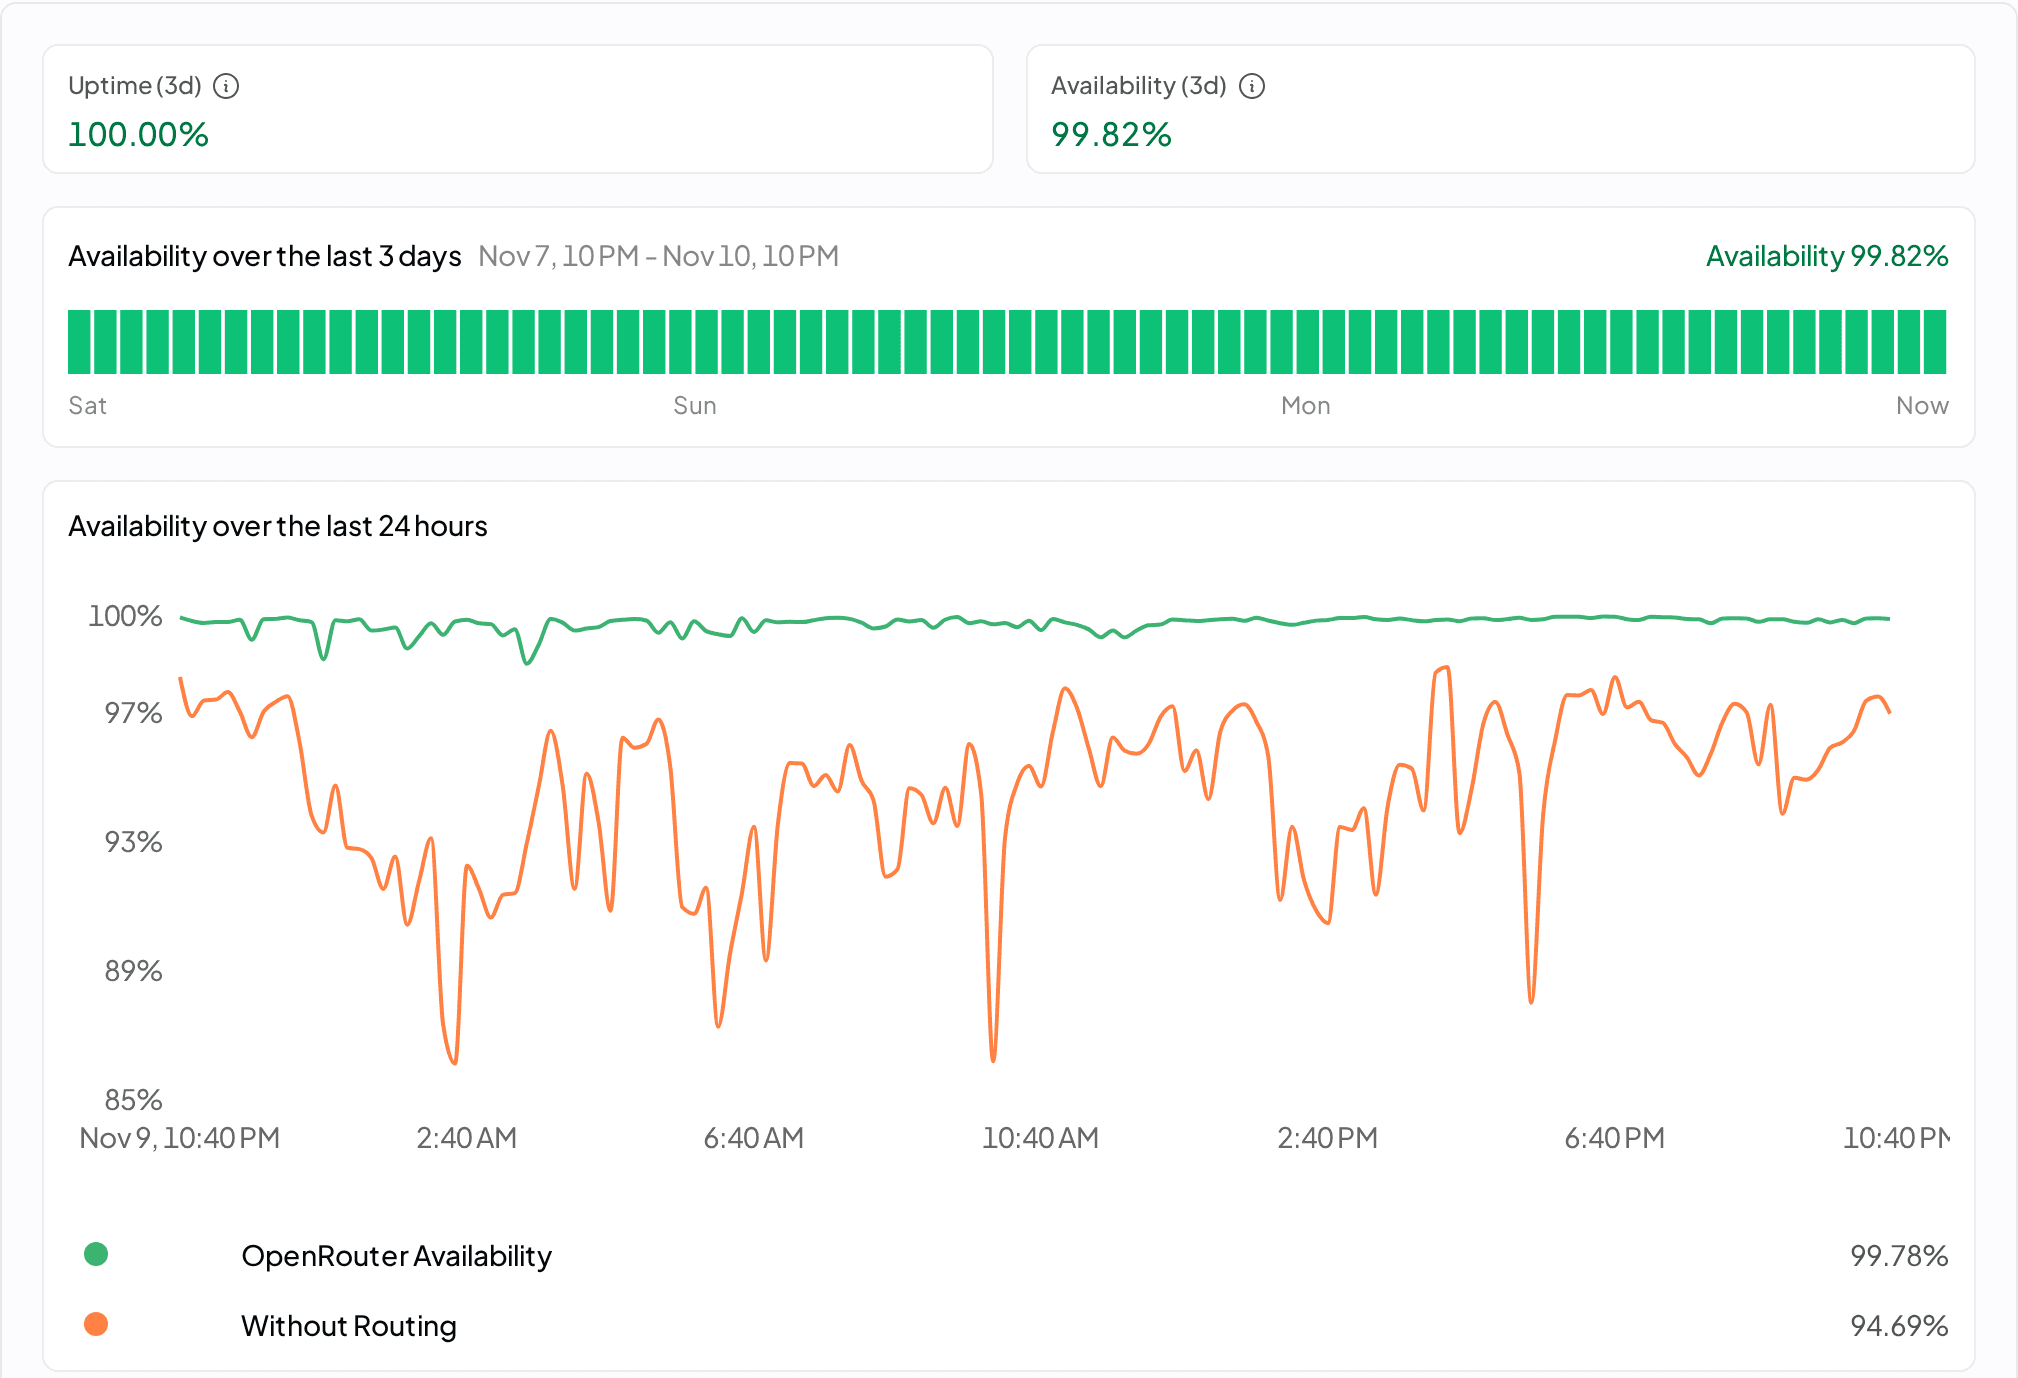
Para cada modelo, coloca primero al proveedor con la mejor capacidad de procesamiento y el mejor tiempo de actividad. «Si este proveedor falla, OpenRouter simplemente pasa de forma automática al siguiente proveedor de la lista», explica. «Seguimos usando nuestro proveedor favorito y, además, esta alternativa de respaldo prácticamente no afecta a nuestro producto».
En un mes, unas 640.000 solicitudes de Prime Intellect fallaron en el primer proveedor que probaron y fueron completadas por otro. «Es una transición muy fluida y nunca notamos ninguna interrupción de nuestro lado», afirma Stu.
Nuevos modelos desde el primer día
Los nuevos modelos llegan a través de la API y la autenticación que el equipo ya utiliza. «Siempre que hay un modelo disponible, podemos usarlo de inmediato», afirma Stu. Prime Intellect ya ejecutaba Kimi K3 y GLM 5.2 en el plazo de un día desde el primer tráfico de cada modelo en OpenRouter. Cuando le preguntan cuánto se tarda en acceder a un nuevo modelo, Will responde: «Depende de cuánto se tarde en escribir el nombre».
«El mayor cambio que OpenRouter aporta a Prime Intellect es la velocidad».
«Como startup, valoramos mucho la velocidad», afirma Stu. «Así es como podemos seguir innovando con todos los modelos que van apareciendo en todo el mundo».
Las evaluaciones forman parte del trabajo diario
El equipo de Will mide lo que puede hacer cada modelo en cargas de trabajo como la programación con agentes y el uso de equipos informáticos. Los modelos abiertos son los candidatos para el posentrenamiento o para generar datos de entrenamiento. Los modelos cerrados sirven como referencia. «Queremos entender a qué distancia estamos de la frontera», dice Will.
Ese trabajo depende de poder acceder a todos los modelos a un coste razonable. «Poder obtener tokens rápidos y fiables a buen precio es simplemente esencial para poder trabajar con datos, evaluaciones y posentrenamiento», afirma.
«El mayor cambio que OpenRouter nos ha aportado es hacer que realizar evaluaciones con cualquier modelo sea fácil y práctico», dice Will, «y que se convierta en algo que forma parte del ciclo de trabajo diario».
Prime Intellect como proveedor
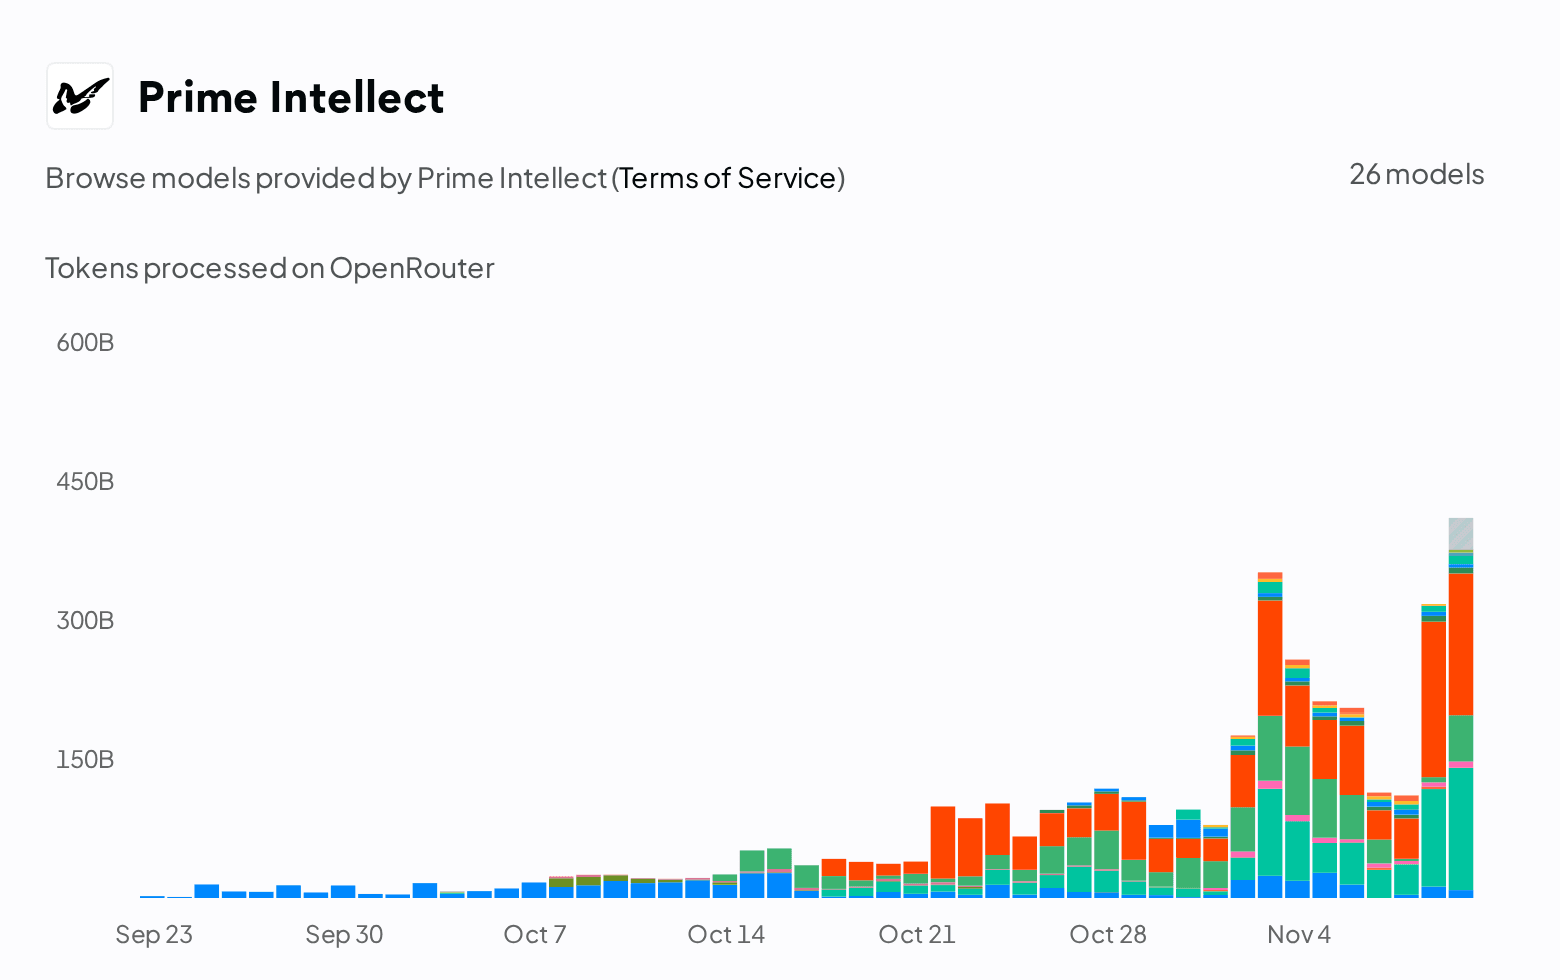
Prime Intellect también vende inferencia en OpenRouter y, en una semana, sirvió 11 modelos y unos 670 mil millones de tokens a casi 48.000 cuentas de OpenRouter, con un volumen semanal de tokens unas 12 veces mayor que el mes anterior. «Es un mercado de inferencia», dice Will. «Es un lugar donde podemos ser tanto consumidores como productores».
Ese tráfico muestra al equipo cómo funciona cada despliegue en producción. «¿Estoy aprovechando bien las cachés? ¿Estoy consiguiendo una buena latencia? ¿Estoy gestionando bien los picos de tráfico?», dice Will. Lo que aprenden se incorpora de nuevo al entrenamiento. «Se entrenan modelos para desplegarlos, y el despliegue determina cómo se entrena el siguiente modelo», afirma.
Stu utiliza los datos por modelo de OpenRouter sobre longitudes de entrada, tokens de razonamiento y de salida y rendimiento para diseñar los clústeres de inferencia de Prime Intellect. «No existe una única configuración de inferencia ideal», afirma. «Puedo aprovechar esos datos para optimizar mi infraestructura de inferencia».
El tiempo de actividad, el rendimiento y el precio de cada proveedor de OpenRouter son públicos, por lo que los usuarios pueden comparar Prime Intellect con todos los demás proveedores que sirven el mismo modelo. «Si ve un proveedor con un tiempo de actividad del 99,99 % y luego ve otro con solo un 80 %, elegirá el que es claramente más fiable», dice Vincent. «Creo que también hemos podido demostrar nuestra solidez en inferencia al mostrarla a través de OpenRouter».
Will ve lo mismo desde ambos lados. «Tanto si tenemos capacidad para alojar un modelo como si la tiene otro, podemos abstraernos de ello, y OpenRouter ha resuelto este problema», afirma.
«Significa que un mundo con múltiples modelos ya está realmente a nuestro alcance».
Más historias de clientes
Sentry
Cómo Sentry puso un límite a las facturas descontroladas de IA sin restringir el acceso
Sentry trasladó su uso interno de IA a OpenRouter, retiró ~500 claves de proveedores y limitó las facturas descontroladas sin restringir la elección de modelos.
Leer historiaDescript
Cómo Descript sacó los nuevos modelos de la cola de ingeniería
Descript ejecuta 13 modelos de cuatro desarrolladores a través de una sola integración con OpenRouter. Cómo redujeron la evaluación de nuevos modelos de una semana a un par de horas.
Leer historiaPax Historia
De una residencia universitaria a 20 millones de rondas: el juego de historia alternativa de Pax Historia
Cómo dos estudiantes de primer año de universidad crearon uno de los juegos de IA con mayor retención de la historia: 35 mil jugadores diarios y 4,87 millones de solicitudes a través de OpenRouter solo el mes pasado.
Leer historiaDesarrolle su producto en OpenRouter
Una API para todos los modelos, con alternativas automáticas entre proveedores.