História de cliente
A Prime Intellect cresceu 100 vezes no OpenRouter e reduziu seu custo por token em 60%
A Prime Intellect desenvolve modelos abertos de ponta e a infraestrutura para treiná-los, servi-los e aprimorá-los. No último ano, seu volume mensal de tokens no OpenRouter cresceu de 11 bilhões para mais de 1 trilhão, enquanto seu custo médio por token caiu cerca de 60%.
Criada para oferecer inteligência por dólar
Prime Intellect desenvolve modelos abertos de fronteira e a infraestrutura para treiná-los, implantá-los e continuar aprimorando-os. Ela aposta que o futuro da IA é multimodelo. “Acreditamos que haverá infinitos modelos que se aprimoram continuamente em diferentes casos de uso”, diz Vincent Weisser, CEO e cofundador da Prime Intellect.
“Queremos garantir que o futuro não seja um único modelo supremo de uma única empresa.”
Os clientes procuram a Prime Intellect para fazer o pós-treinamento de um modelo com seus próprios dados e disponibilizá-lo na plataforma Prime. Antes do pós-treinamento, eles precisam saber de qual modelo partir. “O que o cliente quer ver é o modelo que oferece mais inteligência por dólar”, diz Vincent. “E isso muda literalmente a cada semana, mês ou dia, dependendo de quando novos modelos são lançados.”
Responder a essa pergunta para os clientes e para a própria pesquisa da Prime Intellect significa avaliar novos modelos assim que são lançados. A Prime Intellect executa essas avaliações pelo OpenRouter. Ela usa os resultados para escolher modelos com base no preço e no desempenho e enviar cada carga de trabalho ao modelo mais barato capaz de processá-la.
Mais modelos, mais gastos, mais integrações
“Levamos as avaliações muito a sério. Estamos constantemente avaliando modelos”, diz Will Brown, chefe de pesquisa aplicada na Prime Intellect. Sua equipe testa modelos nos quais pode realizar pós-treinamento ou cujas saídas pode usar como dados de treinamento, portanto um novo modelo precisa se encaixar nos fluxos de trabalho existentes assim que é lançado.
Stu Cao, que lidera o desenvolvimento de inferência da Prime Intellect, recebe essas solicitações. “Todos os dias recebo solicitações constantes da equipe de pesquisa: ‘Ei, este modelo está disponível? Este modelo está disponível?’”, diz ele.
Antes do OpenRouter, cada sim significava conectar a API de mais um provedor e configurar mais um plano de cobrança. Cada provedor tinha seu próprio endpoint, chave de API, autenticação e controles de cache.
“Você está basicamente gerenciando uma grande quantidade de endpoints diferentes e também de chaves de API diferentes. E isso é uma dor de cabeça.”
A confiabilidade de cada modelo também dependia inteiramente do provedor que a equipe usava para acessá-lo. Se esse provedor saísse do ar, todas as solicitações para aquele modelo falhavam, e a equipe não tinha para onde mais enviá-las. “Você está basicamente lidando com muitos pontos únicos de falha”, diz Stu.
Os gastos estavam aumentando ao mesmo tempo. “Vimos nossos gastos internos com inferência entre as equipes aumentarem muito”, diz Vincent.
Por que OpenRouter
A Prime Intellect queria dedicar o tempo de engenharia a harnesses de avaliação e pós-treinamento, em vez de gastar tempo com a complexidade operacional do acesso a modelos de IA. “É muito mais fácil trabalhar em parceria com vocês do que ter que integrar milhares de modelos de centenas de provedores por conta própria”, diz Vincent.
A equipe migrou seu acesso a modelos para o OpenRouter.
“Agora é apenas um endpoint, uma chave de API. Isso deixa nossa pilha de software muito mais limpa e nos permite focar nas camadas superiores.”
Will diz que os pesquisadores já não precisam pensar em onde um modelo está hospedado. “Prefiro muito mais pensar no modelo, no que ele pode fazer, em sua velocidade e eficiência, em vez de pensar na origem da infraestrutura que o disponibiliza”, diz ele. “Poder simplesmente abstrair tudo isso é muito poderoso.”
Os resultados
100x o volume com custo por token cerca de 60% menor
O volume mensal de tokens da Prime Intellect no OpenRouter passou de 11 bilhões em novembro de 2025 para mais de 1 trilhão em setembro de 2026. Nesse período, seu custo médio combinado por milhão de tokens caiu de cerca de US$ 1,23 para cerca de US$ 0,46.
Vincent dá à escolha de modelos os créditos por boa parte disso, chamando-a de “um dos maiores avanços agora nesse mar de centenas de modelos”.
“A questão é como garantir que você sempre encaminhe as solicitações para o melhor modelo e o mais barato.”
A escolha de provedores também ajudou. O OpenRouter envia a Stu dados por modelo sobre tráfego, taxa de processamento, disponibilidade e provedores, e ele os usa para ajustar o roteamento. “O OpenRouter me forneceu uma análise superdetalhada de cada modelo, de como é o tráfego e de quais são as oportunidades de otimização”, diz ele. “Usamos esse feedback, por exemplo, para definir a ordem certa dos provedores. E isso realmente melhorou significativamente nossa eficiência, reduziu nosso custo.”
Interrupções dos provedores já não afetam os usuários
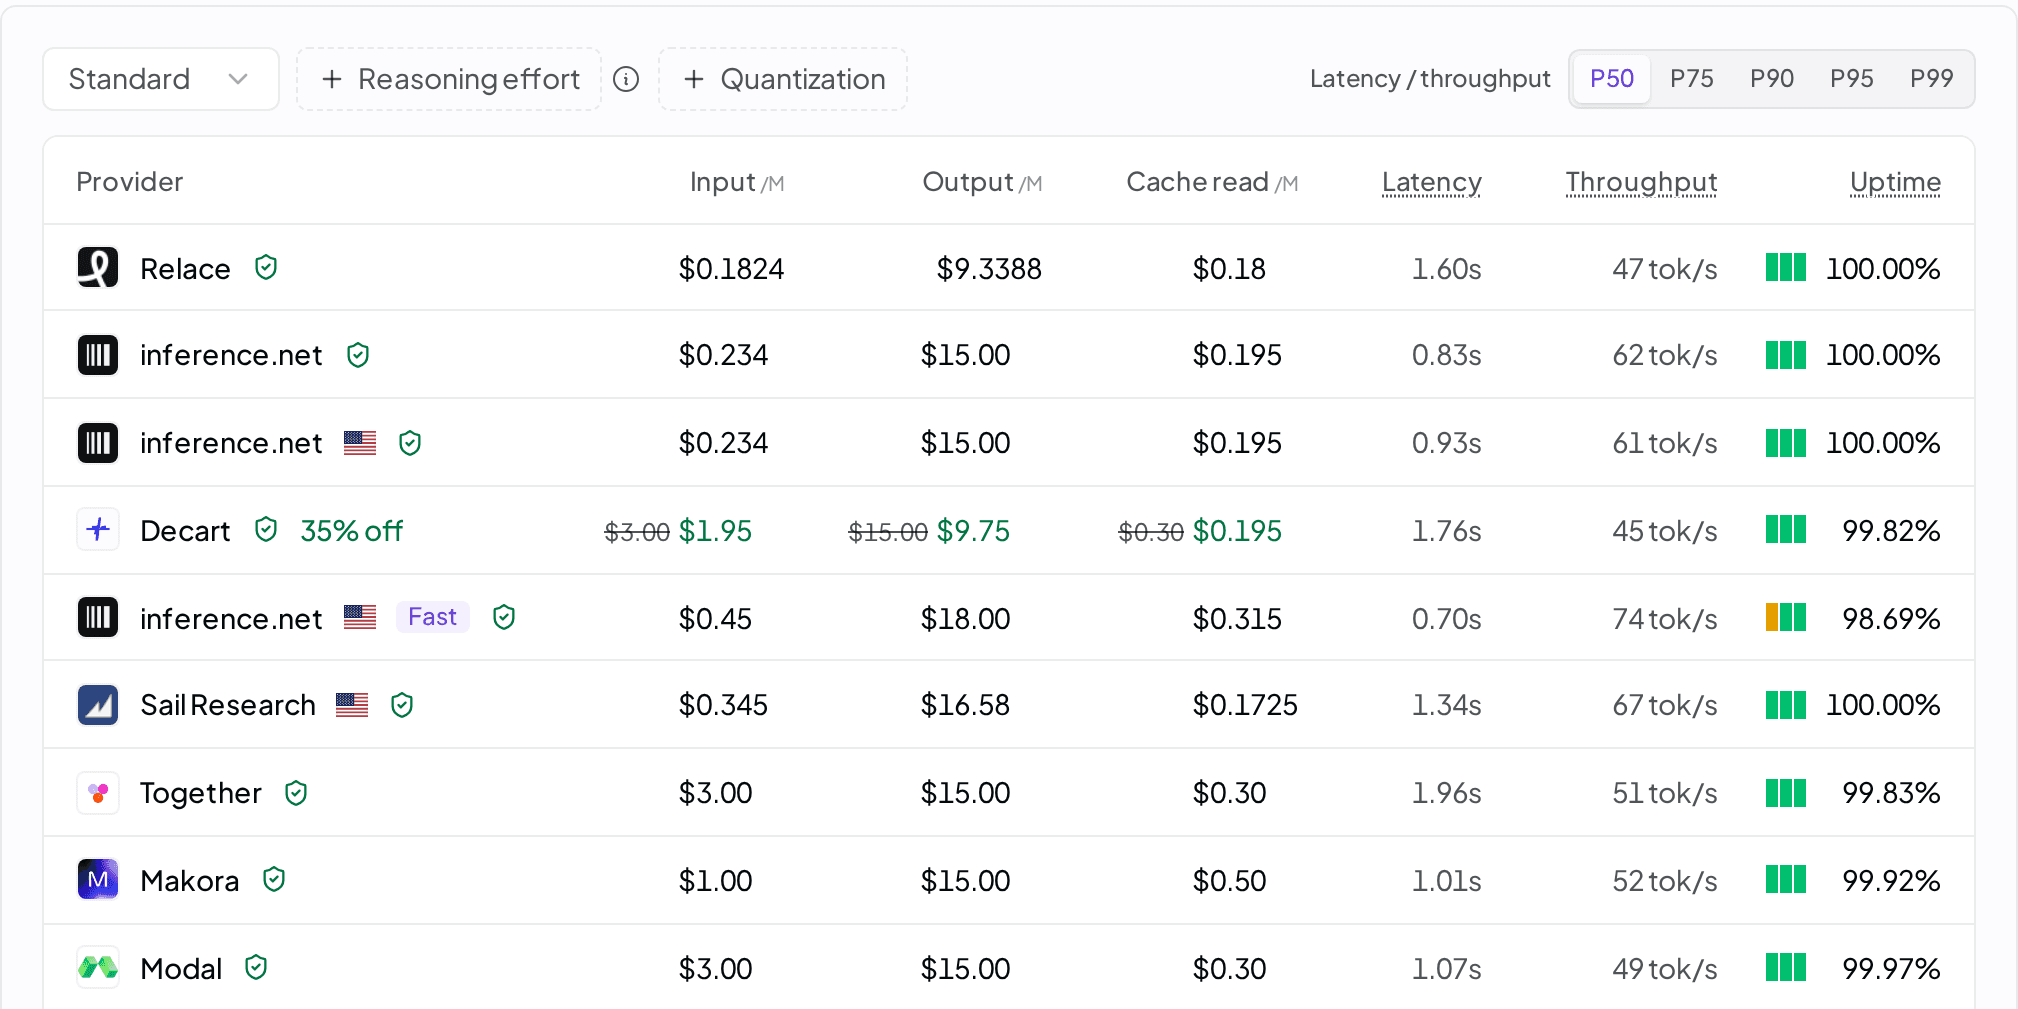
O mesmo modelo pode ter um desempenho muito diferente de um provedor para outro. O OpenRouter mostra a Stu a disponibilidade e a taxa de processamento de cada provedor que serve um modelo. “Isso realmente me deu uma visão muito clara para determinar qual provedor eu escolheria”, diz ele.
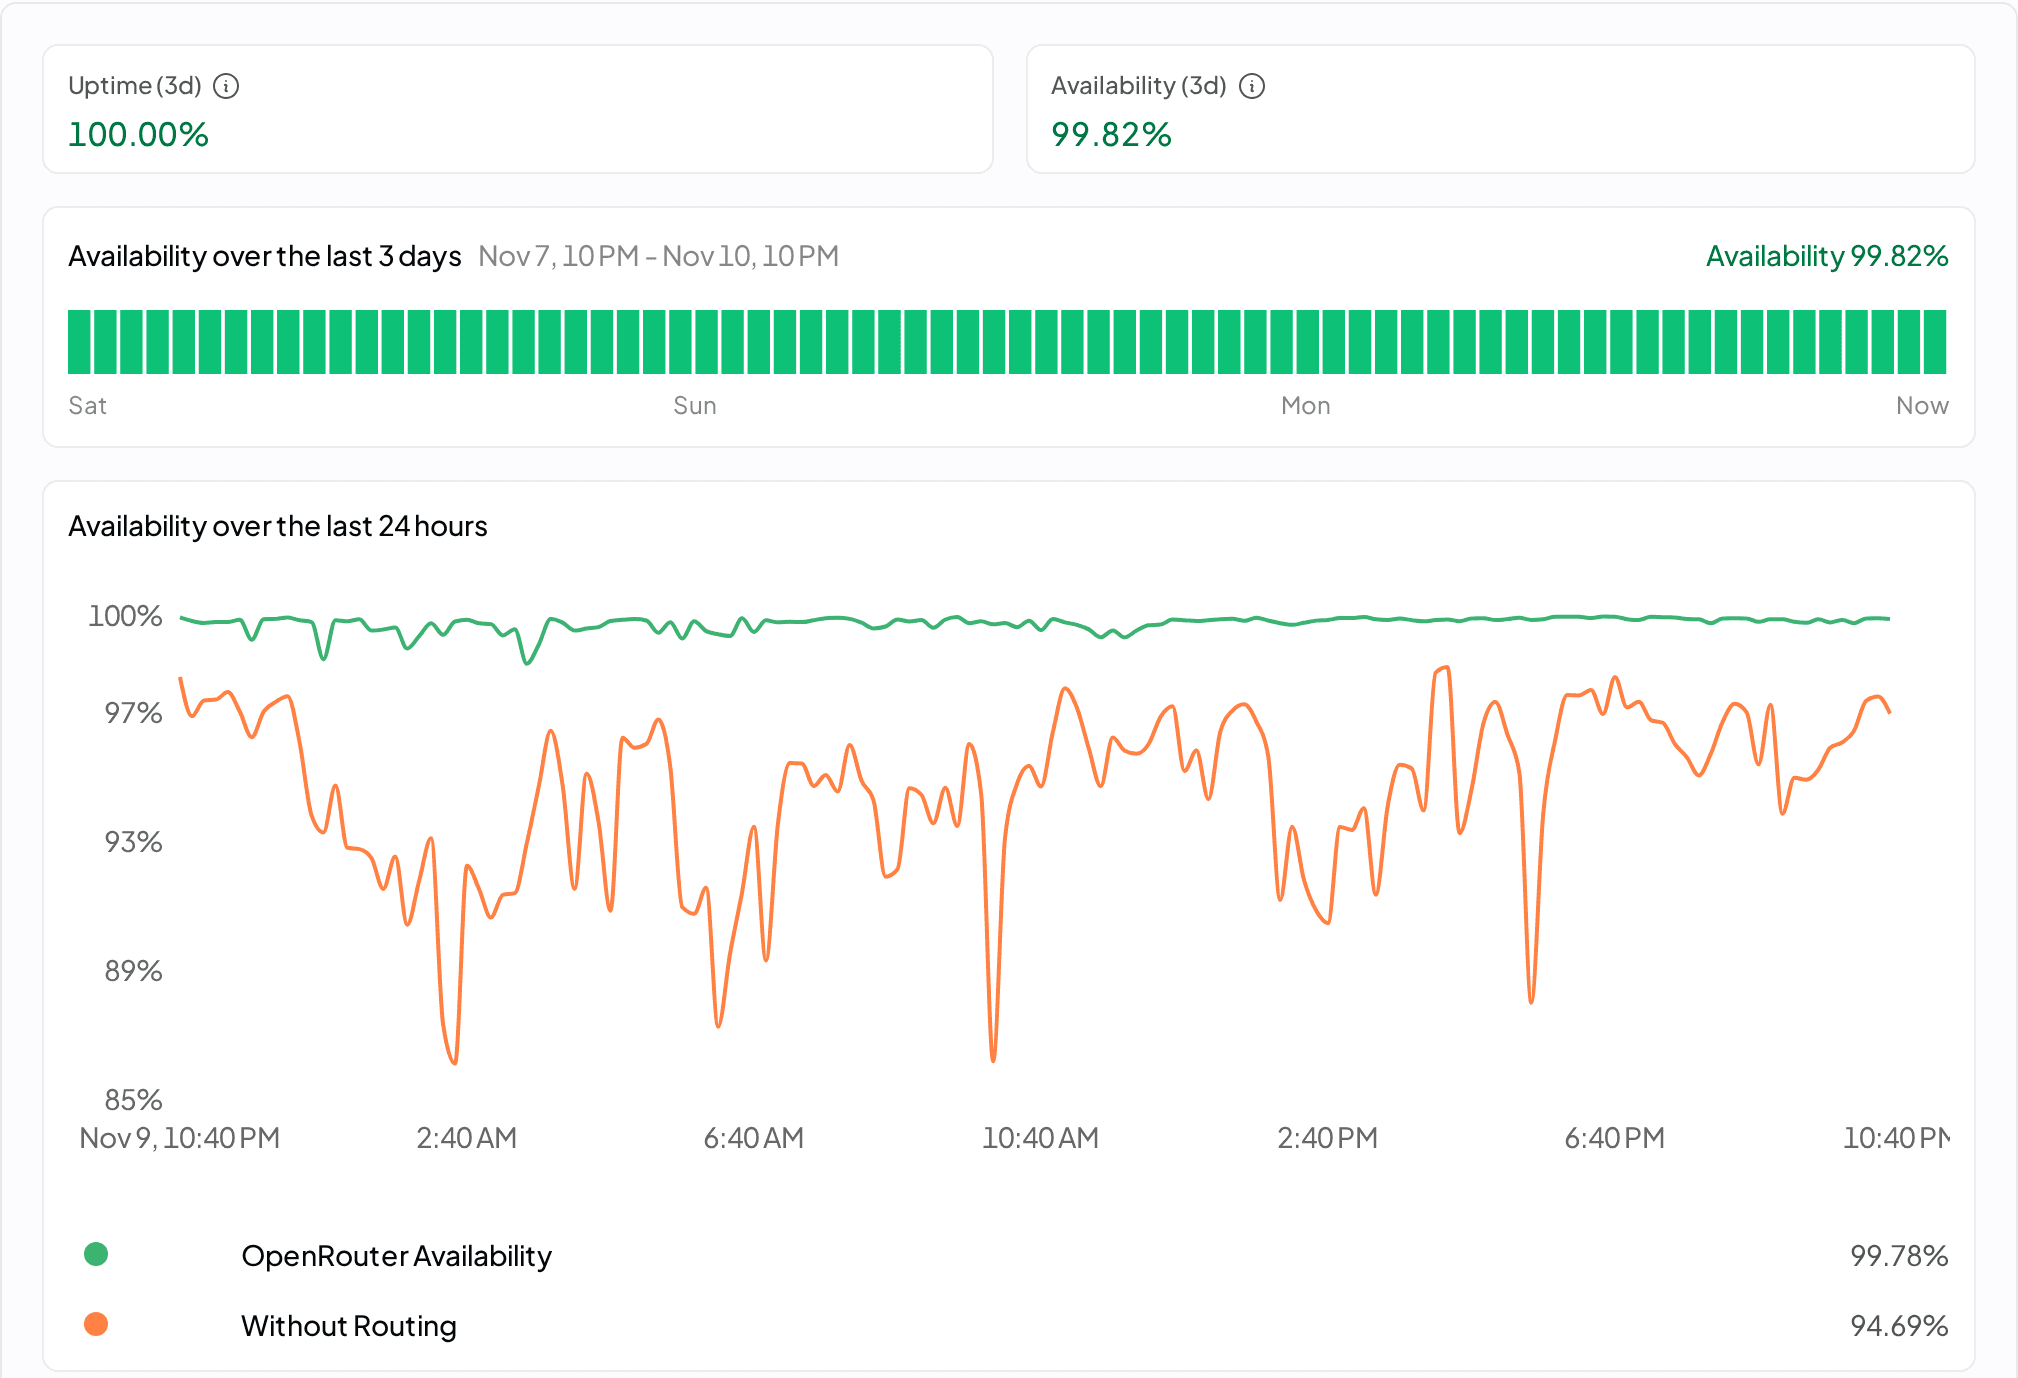
Para cada modelo, ele coloca em primeiro lugar o provedor com a melhor taxa de processamento e disponibilidade. “Se houver uma falha nesse provedor, o OpenRouter simplesmente muda automaticamente para o próximo provedor da lista”, diz ele. “Continuamos usando nosso provedor favorito e essa alternativa basicamente nem sequer afeta nosso produto.”
Em um mês, cerca de 640.000 requisições da Prime Intellect falharam no primeiro provedor testado e foram concluídas por outro. “É uma transição muito tranquila e nunca percebemos nenhuma interrupção do nosso lado”, diz Stu.
Novos modelos desde o primeiro dia
Novos modelos chegam pela API e pela autenticação que a equipe já usa. “Sempre que há um modelo disponível, podemos usá-lo imediatamente”, diz Stu. A Prime Intellect estava executando o Kimi K3 e o GLM 5.2 em até um dia após o primeiro tráfego de cada modelo no OpenRouter. Ao ser perguntado quanto tempo leva para acessar um novo modelo, Will diz: “Depende de quanto tempo leva para digitar o nome.”
“A maior mudança que o OpenRouter traz para a Prime Intellect é a velocidade.”
“Como startup, valorizamos a velocidade”, diz Stu. “É assim que conseguimos continuar inovando com todos os modelos que estão sendo lançados no mundo todo.”
As avaliações fazem parte do trabalho diário
A equipe de Will mede o que cada modelo pode fazer em cargas de trabalho como programação com agentes e uso de computador. Os modelos abertos são os candidatos a pós-treinamento ou à geração de dados de treinamento. Os modelos fechados servem como referências. “Queremos entender a que distância estamos da fronteira”, diz Will.
Esse trabalho depende do acesso a todos os modelos a um custo razoável. “Conseguir tokens com rapidez e confiabilidade a um bom preço é simplesmente essencial para trabalhar com dados, avaliações e pós-treinamento”, diz ele.
“A maior mudança que o OpenRouter trouxe para nós foi tornar as avaliações de qualquer modelo fáceis e práticas”, diz Will, “e o tipo de coisa que simplesmente passa a fazer parte do ciclo do trabalho diário.”
Prime Intellect como provedor
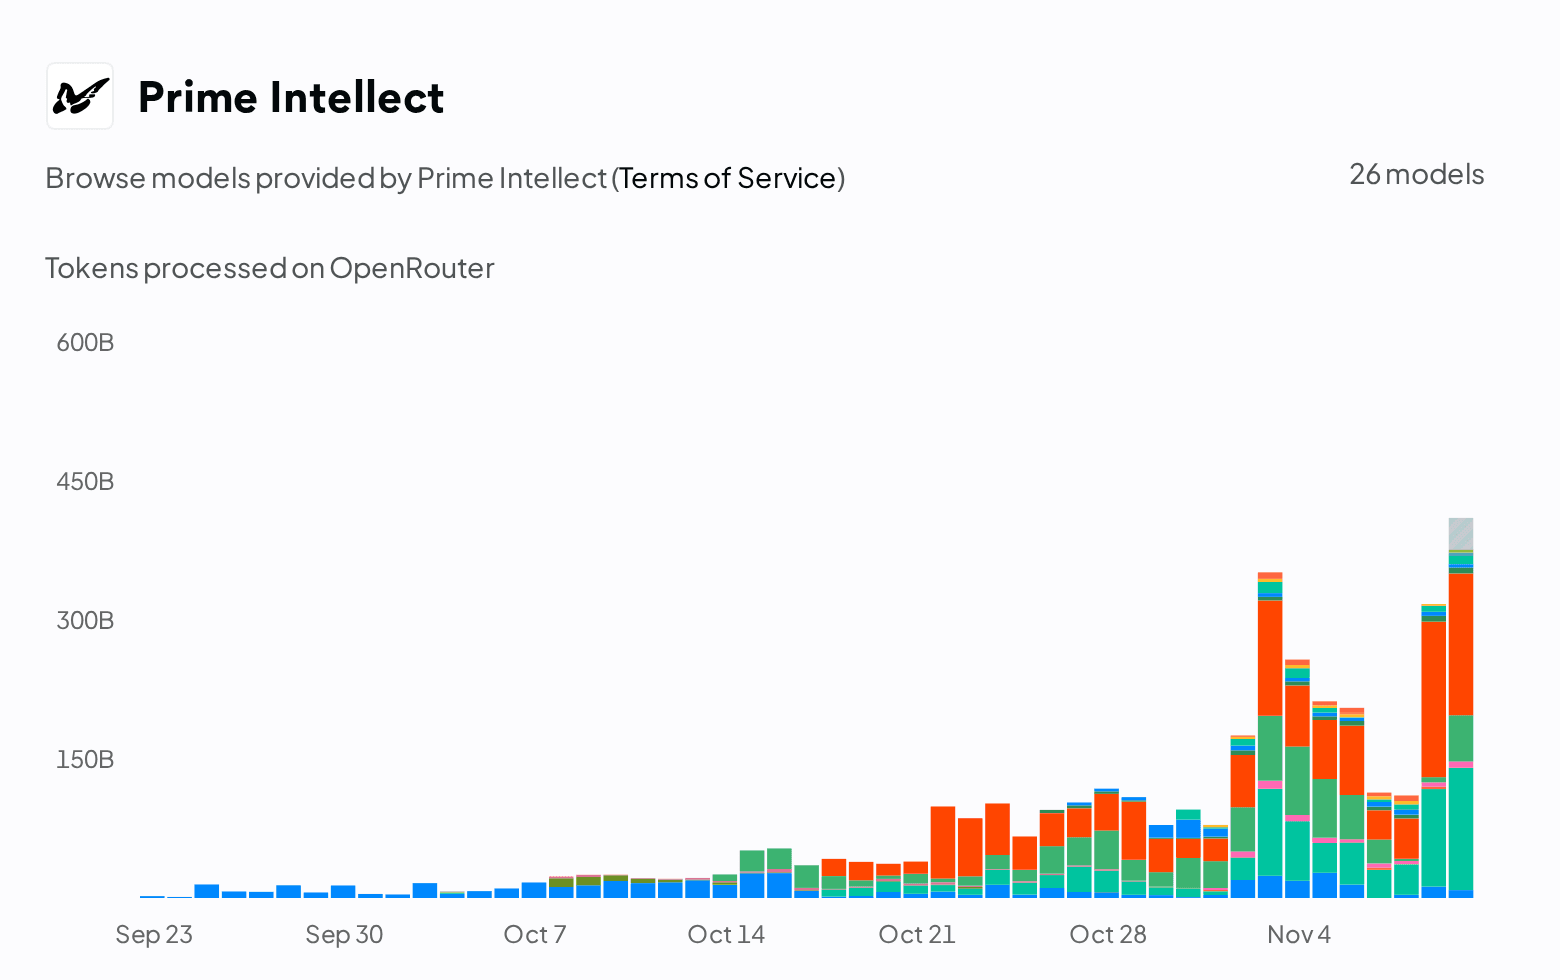
A Prime Intellect também vende inferência no OpenRouter e, em uma semana, disponibilizou 11 modelos e processou ~670 bilhões de tokens para quase 48.000 contas do OpenRouter, com volume semanal de tokens ~12x maior em relação ao mês anterior. “É um marketplace de inferência”, diz Will. “É um lugar onde podemos ser tanto consumidores quanto produtores.”
Esse tráfego mostra à equipe como cada implantação se comporta em produção. “Estou conseguindo bons resultados de cache? Estou conseguindo uma boa latência? Estou lidando bem com os picos?”, diz Will. O que eles aprendem é incorporado ao treinamento. “Você treina modelos para implantação, a implantação molda como você treina o próximo modelo”, diz ele.
Stu usa os dados por modelo do OpenRouter sobre comprimentos de entrada, tokens de raciocínio e de saída e taxa de processamento para projetar os clusters de inferência da Prime Intellect. “Não existe uma única configuração ideal de inferência”, diz ele. “Posso aproveitar esses dados para otimizar minha stack de inferência.”
A disponibilidade, a taxa de processamento e o preço são públicos para todos os provedores no OpenRouter, então os usuários podem comparar a Prime Intellect com todos os outros que disponibilizam o mesmo modelo. “Se você vê um provedor com 99,99% de disponibilidade e depois vê outro com apenas 80%, vai escolher o que é obviamente mais confiável”, diz Vincent. “Acho que conseguimos provar nossa força em inferência também ao demonstrar isso por meio do OpenRouter.”
Will vê a mesma coisa dos dois lados. “Quer tenhamos capacidade para hospedar um modelo, quer outra pessoa tenha, podemos abstrair isso, e o OpenRouter resolveu esse problema”, diz ele.
“Isso significa que um mundo com múltiplos modelos já está bem ao nosso alcance.”
Mais histórias de clientes
Sentry
Como a Sentry limitou gastos descontrolados com IA sem restringir o acesso
A Sentry transferiu o uso interno de IA para o OpenRouter, desativou ~500 chaves de provedores e limitou gastos descontrolados sem restringir a escolha de modelos.
Ler históriaDescript
Como a Descript tirou novos modelos da fila de engenharia
A Descript executa 13 modelos de quatro desenvolvedores por meio de uma única integração com o OpenRouter. Como reduziram a avaliação de novos modelos de uma semana para um par de horas.
Ler históriaPax Historia
Do dormitório universitário a 20 milhões de rodadas: o jogo de história alternativa da Pax Historia
Como dois calouros universitários criaram um dos jogos de IA com maior retenção de todos os tempos — 35 mil jogadores diários, 4,87 milhões de requisições pelo OpenRouter só no mês passado.
Ler históriaDesenvolva seu produto no OpenRouter
Uma API para todos os modelos, com alternativas automáticas entre provedores.