Témoignage client
Prime Intellect a multiplié son volume par 100 sur OpenRouter et réduit son coût par jeton de 60 %
Prime Intellect développe des modèles ouverts de pointe et la pile technologique permettant de les entraîner, de les servir et de les améliorer. Au cours de l’année écoulée, son volume mensuel de jetons sur OpenRouter est passé de 11 milliards à plus de 1 000 milliards, tandis que son coût moyen par jeton a baissé d’environ 60 %.
Conçu pour l’intelligence par dollar
Prime Intellect développe des modèles ouverts de pointe et l’infrastructure pour les entraîner, les déployer et continuer à les améliorer. L’entreprise parie sur un avenir de l’IA multimodèle. « Nous pensons qu’il y aura une infinité de modèles qui s’amélioreront continuellement d’eux-mêmes pour différents cas d’usage », déclare Vincent Weisser, PDG et cofondateur de Prime Intellect.
« Nous voulons nous assurer que l’avenir ne se résumera pas à un modèle tout-puissant créé par une seule entreprise. »
Les clients font appel à Prime Intellect pour effectuer le post-entraînement d’un modèle sur leurs propres données et le servir sur la plateforme Prime. Avant ce post-entraînement, ils doivent savoir de quel modèle partir. « Ce qu’un client veut voir, c’est le modèle qui lui offre le plus d’intelligence par dollar », explique Vincent. « Et cela change littéralement chaque semaine, chaque mois ou chaque jour, selon la date de sortie des nouveaux modèles. »
Répondre à cette question pour les clients et pour les propres recherches de Prime Intellect implique d’évaluer les nouveaux modèles dès leur sortie. Prime Intellect effectue ces évaluations via OpenRouter. L’entreprise utilise les résultats pour choisir les modèles en fonction du prix et des performances et envoyer chaque charge de travail au modèle le moins cher capable de la traiter.
Plus de modèles, plus de dépenses, plus d’intégrations
« Nous prenons les évaluations très au sérieux. Nous évaluons constamment les modèles », explique Will Brown, responsable de la recherche appliquée chez Prime Intellect. Son équipe teste des modèles qu’elle pourrait soumettre à un post-entraînement, ou dont elle pourrait utiliser les sorties comme données d’entraînement, si bien qu’un nouveau modèle doit pouvoir s’intégrer à ses flux de travail existants dès sa sortie.
Stu Cao, qui dirige le développement de l’inférence chez Prime Intellect, reçoit ces demandes. « Chaque jour, je reçois sans cesse des demandes de l’équipe de recherche : “Dites, ce modèle est-il disponible ? Ce modèle est-il disponible ?” », explique-t-il.
Avant OpenRouter, chaque oui impliquait de connecter l’API d’un autre fournisseur et de mettre en place un autre plan de facturation. Chaque fournisseur avait son propre point de terminaison, sa propre clé API, ainsi que ses propres contrôles d’authentification et de mise en cache.
« Vous devez en fait gérer une multitude de points de terminaison différents, ainsi que différentes clés API. Et c’est un casse-tête. »
La fiabilité de chaque modèle dépendait aussi entièrement du fournisseur utilisé par l’équipe pour y accéder. Si ce fournisseur tombait en panne, toutes les requêtes destinées à ce modèle échouaient, et l’équipe n’avait aucune autre destination où les envoyer. « Vous vous retrouvez en fait avec de nombreux points uniques de défaillance », explique Stu.
Les dépenses augmentaient en parallèle. « Nous avons vu nos dépenses internes d’inférence augmenter fortement dans l’ensemble de nos équipes », explique Vincent.
Pourquoi OpenRouter
Prime Intellect souhaitait consacrer son temps d’ingénierie aux harness d’évaluation et au post-entraînement plutôt qu’à la complexité opérationnelle de l’accès aux modèles d’IA. « Il est bien plus simple de travailler avec vous que d’intégrer nous-mêmes des milliers de modèles auprès de centaines de fournisseurs », explique Vincent.
L’équipe a transféré son accès aux modèles vers OpenRouter.
« Désormais, il suffit d’un point de terminaison et d’une clé API. Notre pile logicielle est beaucoup plus épurée et nous nous concentrons sur ses couches supérieures. »
Will explique que les chercheurs n’ont plus à se préoccuper de l’endroit où un modèle est hébergé. « Je préfère de loin réfléchir au modèle, à ses capacités, à sa rapidité et à son efficacité, plutôt qu’à la source sous-jacente dont il provient », dit-il. « Pouvoir simplement faire abstraction de tout cela est très puissant. »
Les résultats
Un volume multiplié par 100 pour un coût par jeton inférieur d’environ 60 %
Le volume mensuel de jetons de Prime Intellect sur OpenRouter est passé de 11 milliards en novembre 2025 à plus de 1 000 milliards en septembre 2026. Sur cette période, son coût moyen par million de jetons est passé d’environ 1,23 $ à environ 0,46 $.
Vincent met une grande partie de ces résultats au crédit du choix de modèles, qu’il décrit comme « l’un des plus grands leviers aujourd’hui dans cet océan de centaines de modèles ».
« La véritable question est de savoir comment garantir que les requêtes sont toujours acheminées vers le meilleur modèle au coût le plus bas. »
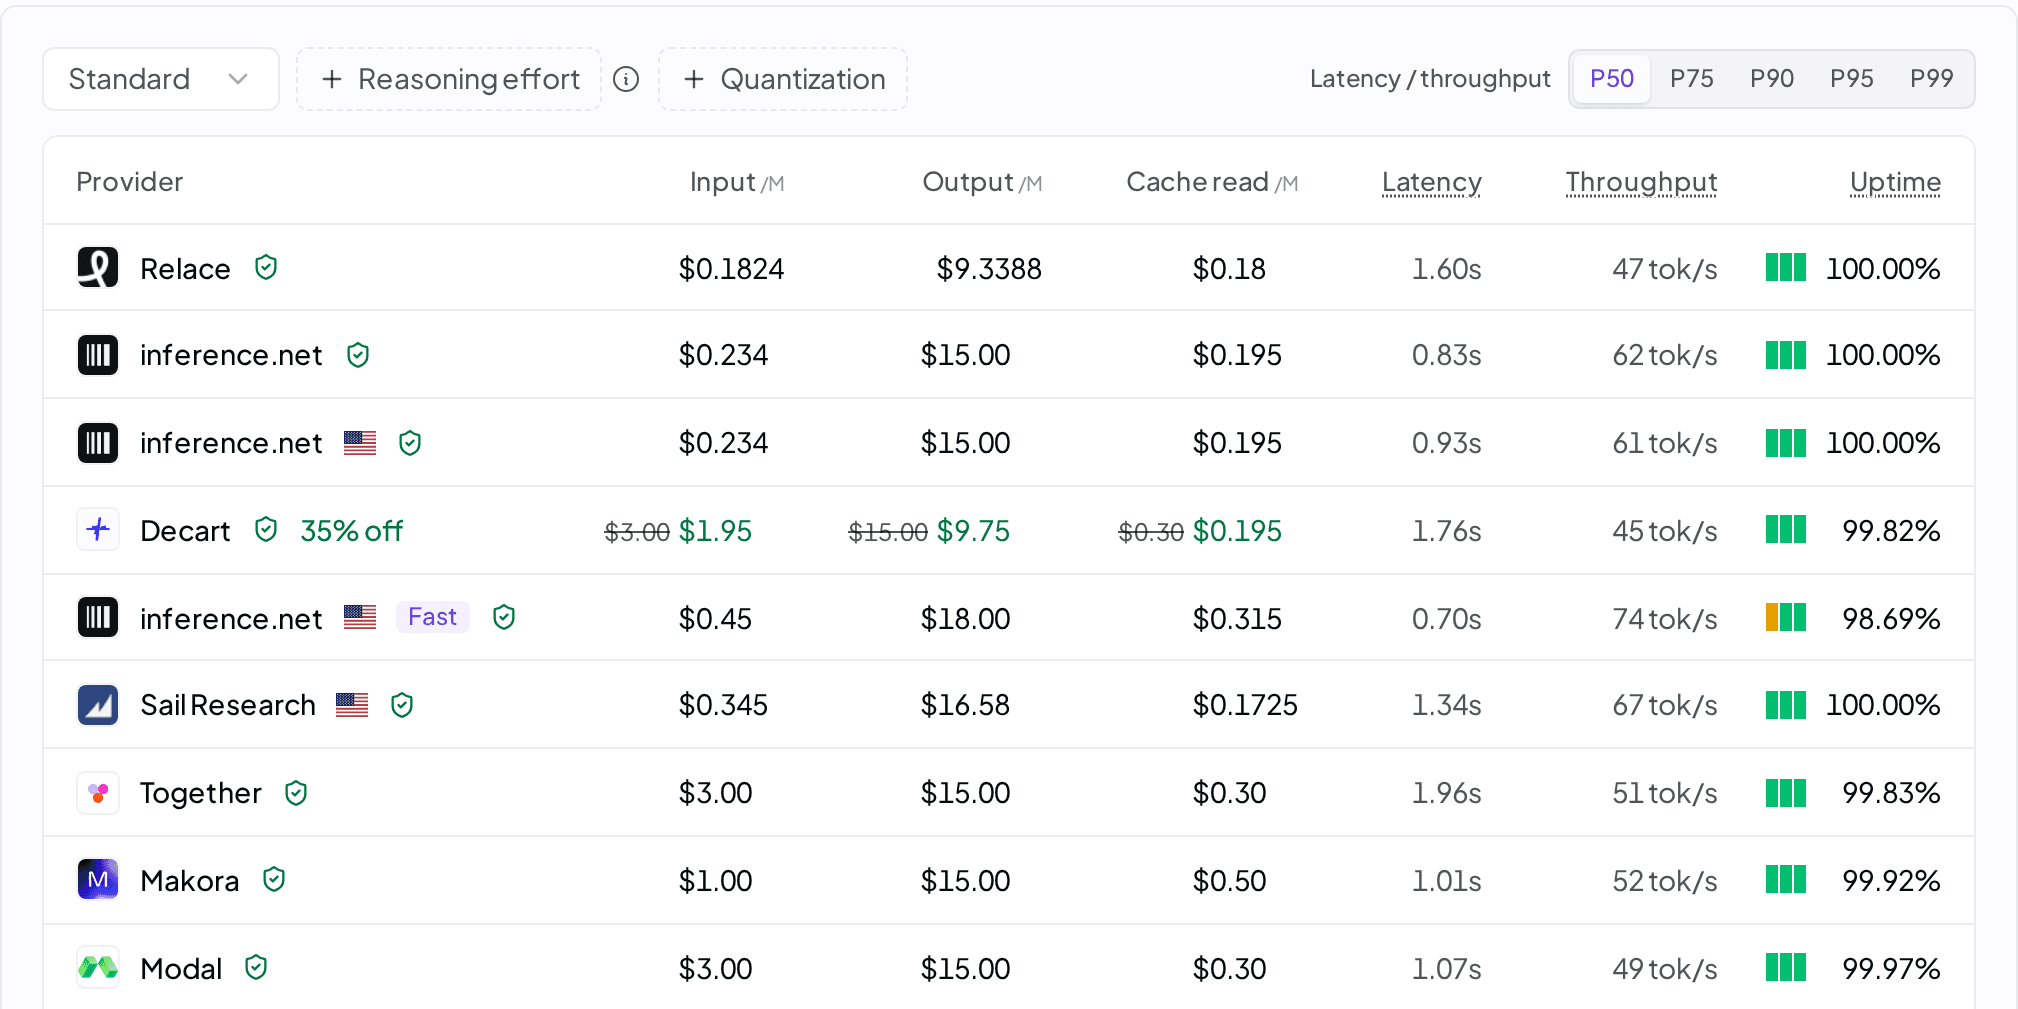
Le choix des fournisseurs a également joué un rôle. OpenRouter transmet à Stu des données par modèle sur le trafic, le débit, la disponibilité et les fournisseurs, qu’il utilise pour affiner le routage. « OpenRouter m’a fourni une analyse très détaillée pour chaque modèle, sur le profil du trafic et les possibilités d’optimisation », explique-t-il. « Nous utilisons ces retours, par exemple, pour définir le bon ordre des fournisseurs. Et cela a considérablement amélioré notre efficacité et réduit nos coûts. »
Les pannes des fournisseurs ne touchent plus les utilisateurs
Un même modèle peut offrir des performances très différentes d’un fournisseur à l’autre. OpenRouter montre à Stu la disponibilité et le débit de chaque fournisseur proposant un modèle. « Cela m’a vraiment donné une vision très claire pour déterminer quel fournisseur choisir », explique-t-il.
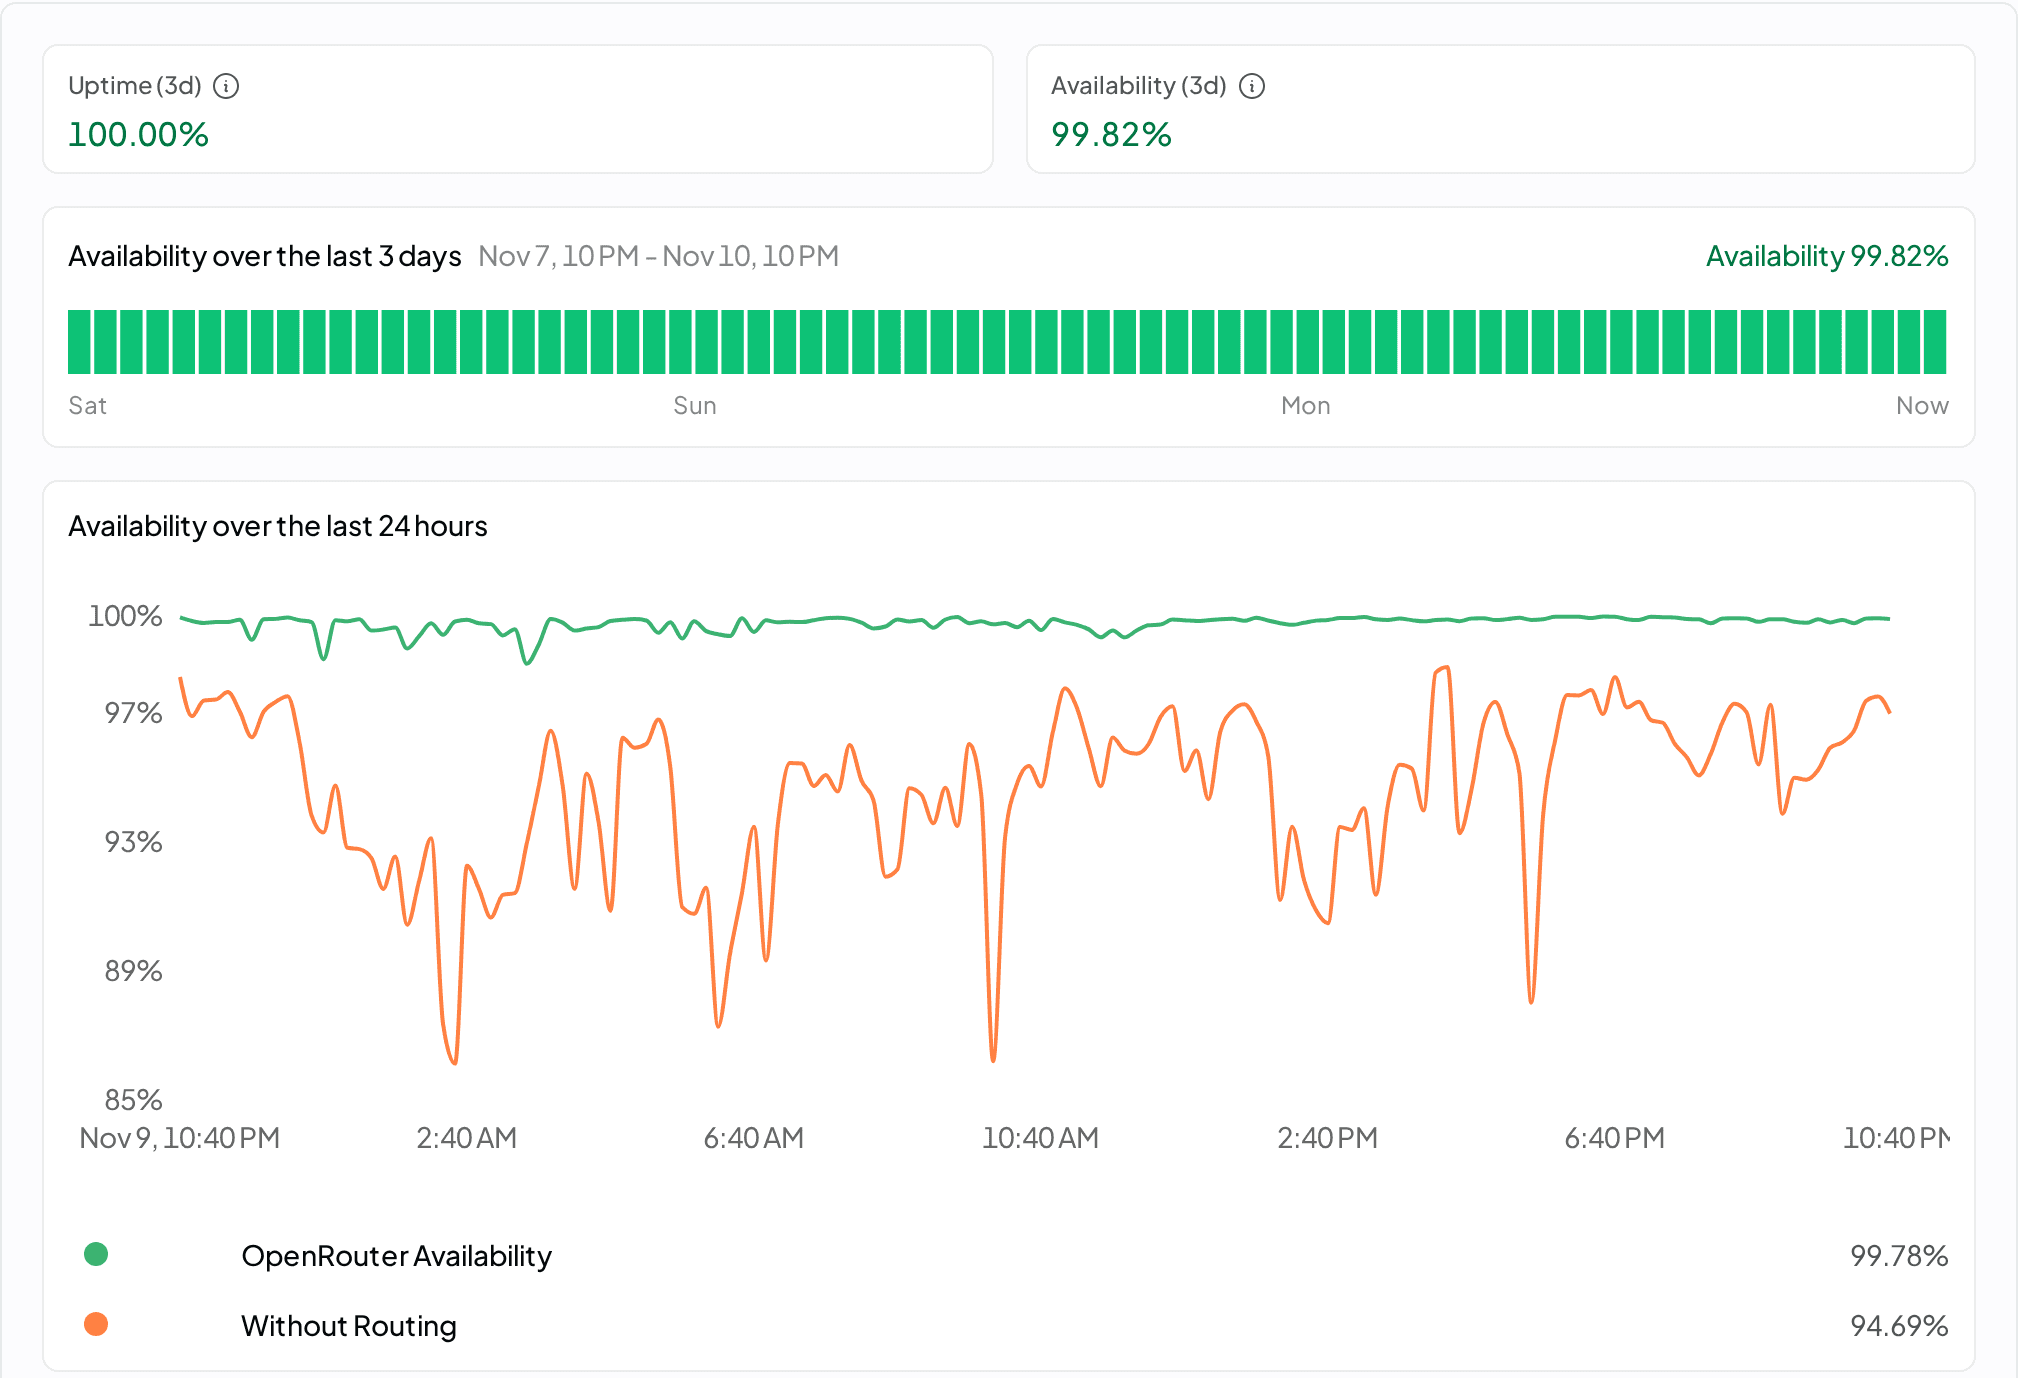
Pour chaque modèle, il place en premier le fournisseur offrant le meilleur débit et la meilleure disponibilité. « En cas de défaillance de ce fournisseur, OpenRouter passe automatiquement au fournisseur suivant dans la liste », explique-t-il. « Nous continuons à utiliser notre fournisseur préféré et ce basculement n’a pratiquement aucun impact sur notre produit. »
En un mois, environ 640 000 requêtes de Prime Intellect ont échoué chez le premier fournisseur sollicité et ont été traitées par un autre. « La transition est très fluide et nous ne remarquons vraiment jamais de panne de notre côté », explique Stu.
De nouveaux modèles dès le premier jour
Les nouveaux modèles sont accessibles via l’API et l’authentification que l’équipe utilise déjà. « Dès qu’un modèle est disponible, nous pouvons l’utiliser immédiatement », explique Stu. Prime Intellect utilisait Kimi K3 et GLM 5.2 moins d’un jour après les premières requêtes adressées à chacun de ces modèles sur OpenRouter. Interrogé sur le temps nécessaire pour accéder à un nouveau modèle, Will répond : « Cela dépend du temps qu’il faut pour saisir son nom. »
« Le plus grand changement qu’OpenRouter apporte à Prime Intellect, c’est la vitesse d’exécution. »
« En tant que startup, nous tenons à cette vitesse d’exécution », explique Stu. « C’est ainsi que nous pouvons continuer à innover avec tous les modèles qui sortent dans le monde entier. »
Les évaluations font partie du travail quotidien
L’équipe de Will mesure les capacités de chaque modèle sur des tâches telles que le développement de code agentique et l’utilisation d’un ordinateur. Les modèles ouverts sont les candidats au post-entraînement ou à la génération de données d’entraînement. Les modèles fermés servent de références. « Nous voulons comprendre à quelle distance nous sommes des modèles de pointe », explique Will.
Ce travail dépend de la possibilité d’accéder à chaque modèle à un coût raisonnable. « Pouvoir obtenir des tokens rapidement, de manière fiable et à un bon prix est tout simplement essentiel pour travailler sur les données, les évaluations et le post-entraînement », explique-t-il.
« Le plus grand changement qu’OpenRouter nous a apporté, c’est de rendre les évaluations sur n’importe quel modèle simples et pratiques, dit Will, au point qu’elles s’intègrent naturellement au cycle du travail quotidien. »
Prime Intellect en tant que fournisseur
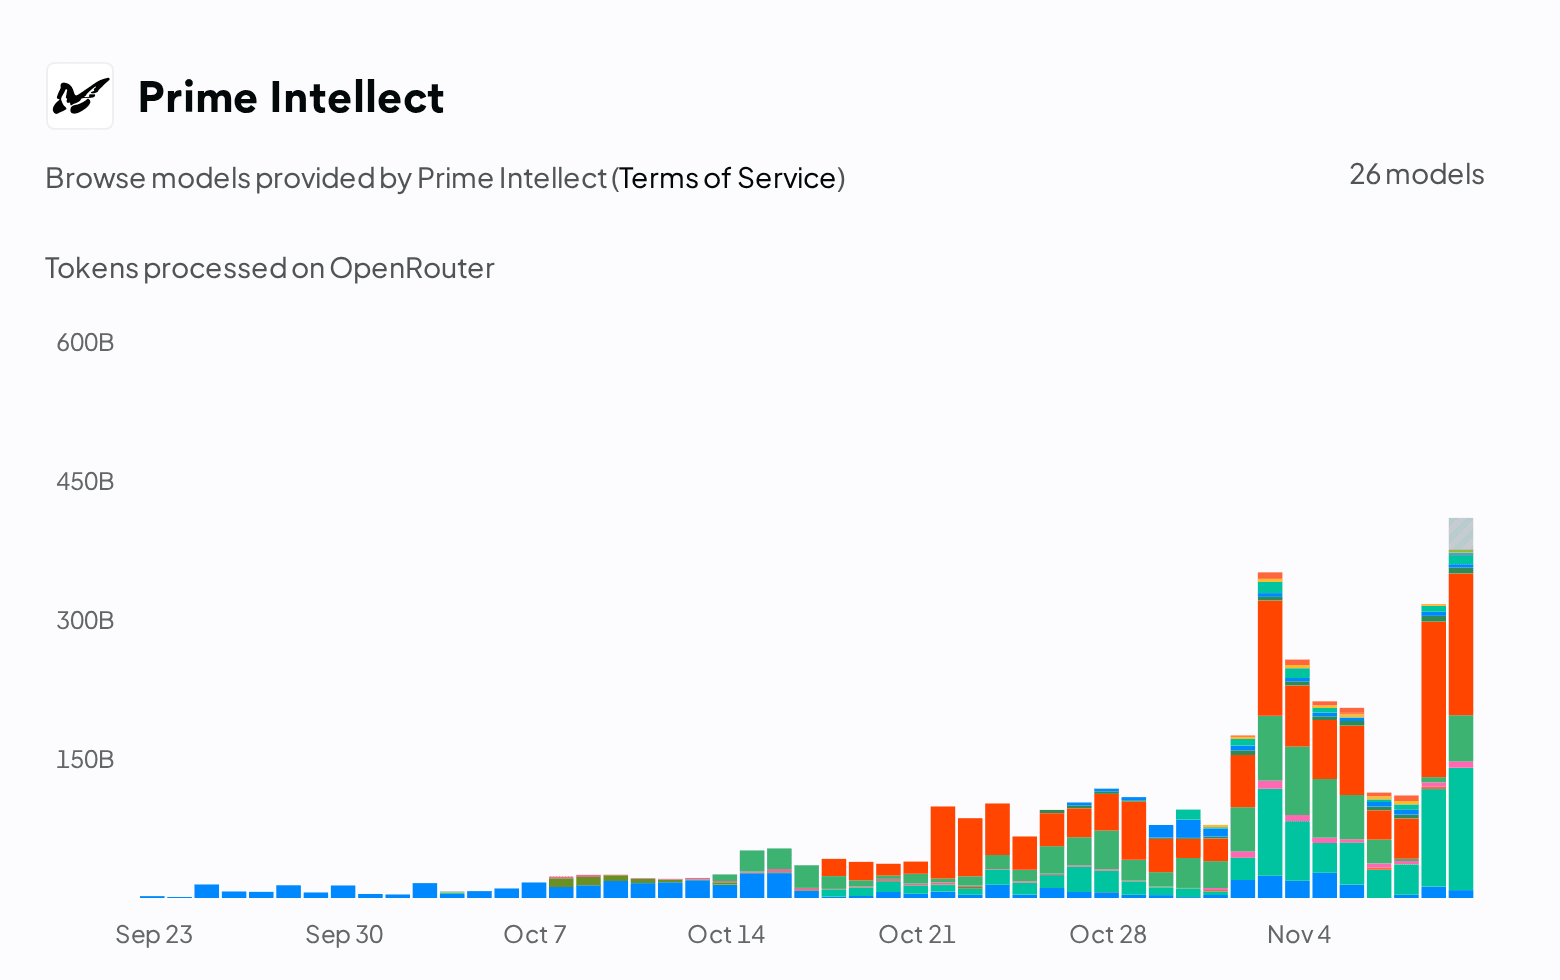
Prime Intellect vend également de l’inférence sur OpenRouter et, en une semaine, a servi 11 modèles et environ 670 milliards de jetons à près de 48 000 comptes OpenRouter, avec un volume hebdomadaire de jetons multiplié par environ 12 par rapport au mois précédent. « C’est une place de marché pour l’inférence », explique Will. « C’est un espace où nous pouvons être à la fois consommateurs et producteurs. »
Ce trafic montre à l’équipe les performances de chaque déploiement en production. « Mes caches sont-ils efficaces ? Ma latence est-elle bonne ? Est-ce que je gère bien les pics de trafic ? » explique Will. Les enseignements tirés sont réinjectés dans l’entraînement. « On entraîne les modèles pour les déployer, et le déploiement façonne la manière dont on entraîne le modèle suivant », explique-t-il.
Stu utilise les données par modèle d’OpenRouter sur la longueur des entrées, les jetons de raisonnement et de sortie et le débit pour concevoir les clusters d’inférence de Prime Intellect. « Il n’existe pas de configuration d’inférence idéale pour tous les cas », explique-t-il. « Je peux exploiter ces données pour optimiser ma pile d’inférence. »
La disponibilité, le débit et le prix de chaque fournisseur sur OpenRouter sont publics, ce qui permet aux utilisateurs de comparer Prime Intellect à tous les autres fournisseurs qui servent le même modèle. « Si vous voyez un fournisseur avec une disponibilité de 99,99 %, puis un autre avec seulement 80 %, vous choisirez celui qui est manifestement le plus fiable », explique Vincent. « Je pense que nous avons aussi pu démontrer notre expertise en inférence en la mettant en avant sur OpenRouter. »
Will fait le même constat des deux côtés. « Que nous ayons la capacité d’héberger un modèle ou que quelqu’un d’autre l’ait, nous pouvons faire abstraction de cette question, et OpenRouter a résolu ce problème », explique-t-il.
« Cela signifie qu’un monde multimodèle est déjà tout à fait à notre portée. »
Autres témoignages clients
Sentry
Comment Sentry a plafonné les factures d’IA incontrôlées sans restreindre l’accès
Sentry a transféré son utilisation interne de l’IA vers OpenRouter, retiré environ 500 clés de fournisseurs et plafonné les factures incontrôlées sans restreindre le choix des modèles.
Lire le témoignageDescript
Comment Descript a retiré les nouveaux modèles de la file d’attente de l’équipe d’ingénierie
Descript utilise 13 modèles de quatre développeurs via une seule intégration OpenRouter. Comment l’entreprise a réduit l’évaluation des nouveaux modèles d’une semaine à quelques heures.
Lire le témoignagePax Historia
D’une chambre universitaire à 20 millions de parties : le jeu d’uchronie de Pax Historia
Comment deux étudiants en première année d’université ont créé l’un des jeux d’IA au meilleur taux de rétention jamais atteint — 35 000 joueurs quotidiens, 4,87 millions de requêtes via OpenRouter rien que le mois dernier.
Lire le témoignageDéveloppez votre produit sur OpenRouter
Une API pour tous les modèles, avec des basculements automatiques vers des fournisseurs de secours.