Kundenbericht
Prime Intellect wuchs auf OpenRouter um das 100-Fache und senkte seine Kosten pro Token um 60 %
Prime Intellect entwickelt offene Spitzenmodelle und den Stack, um sie zu trainieren, bereitzustellen und zu verbessern. Im vergangenen Jahr stieg sein monatliches Token-Volumen auf OpenRouter von 11 Milliarden auf mehr als 1 Billion, während seine durchschnittlichen Kosten pro Token um etwa 60 % sanken.
Entwickelt für Intelligenz pro Dollar
Prime Intellect entwickelt offene Spitzenmodelle und die Infrastruktur, um sie zu trainieren, bereitzustellen und kontinuierlich zu verbessern. Das Unternehmen setzt darauf, dass die Zukunft der KI auf vielen Modellen basiert. „Wir glauben, dass es unendlich viele Modelle sein werden, die sich für unterschiedliche Anwendungsfälle kontinuierlich selbst verbessern“, sagt Vincent Weisser, CEO und Mitgründer von Prime Intellect.
„Wir wollen sicherstellen, dass die Zukunft nicht aus einem einzigen allmächtigen Modell eines einzigen Unternehmens besteht.“
Kunden kommen zu Prime Intellect, um ein Modell mit ihren eigenen Daten nachzutrainieren und auf der Prime-Plattform bereitzustellen. Vor dem Nachtraining müssen sie wissen, welches Modell sie als Ausgangspunkt wählen sollen. „Ein Kunde möchte das Modell sehen, das ihm die meiste Intelligenz pro Dollar bietet“, sagt Vincent. „Und das ändert sich buchstäblich jede Woche oder jeden Monat oder jeden Tag, je nachdem, wann neue Modelle erscheinen.“
Diese Frage für Kunden und für die eigene Forschung von Prime Intellect zu beantworten, bedeutet, neue Modelle unmittelbar nach ihrer Veröffentlichung zu evaluieren. Prime Intellect führt diese Evaluierungen über OpenRouter durch. Anhand der Ergebnisse wählt das Unternehmen Modelle nach Preis und Leistung aus und leitet jede Arbeitslast an das günstigste Modell weiter, das sie bewältigen kann.
Mehr Modelle, mehr Ausgaben, mehr Integrationen
„Wir nehmen Evaluierungen sehr ernst. Wir evaluieren ständig Modelle“, sagt Will Brown, Head of Applied Research bei Prime Intellect. Sein Team testet Modelle, die es möglicherweise nachtrainiert oder deren Ausgaben es möglicherweise als Trainingsdaten verwendet, daher muss ein neues Modell sofort nach seiner Veröffentlichung in die bestehenden Workflows passen.
Stu Cao, der die Inferenzentwicklung bei Prime Intellect leitet, erhält diese Anfragen. „Jeden Tag bekomme ich ständig Anfragen vom Forschungsteam: ‚Hey, ist dieses Modell verfügbar? Ist dieses Modell verfügbar?‘“, sagt er.
Vor OpenRouter bedeutete jedes Ja, die API eines weiteren Anbieters anzubinden und einen weiteren Abrechnungstarif einzurichten. Jeder Anbieter hatte einen eigenen Endpunkt, einen eigenen API-Schlüssel sowie eigene Authentifizierungs- und Caching-Einstellungen.
„Im Grunde verwalten Sie Unmengen verschiedener Endpunkte und auch verschiedener API-Schlüssel. Und das bereitet Kopfzerbrechen.“
Die Zuverlässigkeit jedes Modells hing außerdem vollständig von dem Anbieter ab, über den das Team darauf zugriff. Wenn dieser Anbieter ausfiel, schlug jede Anfrage an dieses Modell fehl, und das Team konnte sie nirgendwo anders hinschicken. „Im Grunde haben Sie es mit vielen einzelnen Ausfallpunkten zu tun“, sagt Stu.
Gleichzeitig stiegen die Ausgaben. „Wir haben gesehen, dass unsere internen Inferenzausgaben über alle Teams hinweg stark gestiegen sind“, sagt Vincent.
Warum OpenRouter
Prime Intellect wollte Entwicklungszeit in Evaluierungs-Harnesses und Post-Training investieren, statt sich mit der betrieblichen Komplexität des Zugriffs auf KI-Modelle zu beschäftigen. „Es ist viel einfacher, mit Ihnen zusammenzuarbeiten, als selbst Tausende von Modellen von Hunderten von Anbietern integrieren zu müssen“, sagt Vincent.
Das Team stellte seinen Modellzugriff auf OpenRouter um.
„Jetzt sind es nur noch ein Endpunkt und ein API-Schlüssel. Dadurch wird unser Software-Stack viel übersichtlicher, und wir konzentrieren uns auf die oberen Schichten des Stacks.“
Will sagt, Forschende müssten nicht mehr darüber nachdenken, wo ein Modell gehostet wird. „Ich denke viel lieber über das Modell nach, was es kann, wie schnell es ist und wie effizient es ist, statt darüber, aus welcher zugrunde liegenden Quelle es stammt“, sagt er. „Das einfach abstrahieren zu können, ist sehr wirkungsvoll.“
Die Ergebnisse
100-faches Volumen bei rund 60 % niedrigeren Kosten pro Token
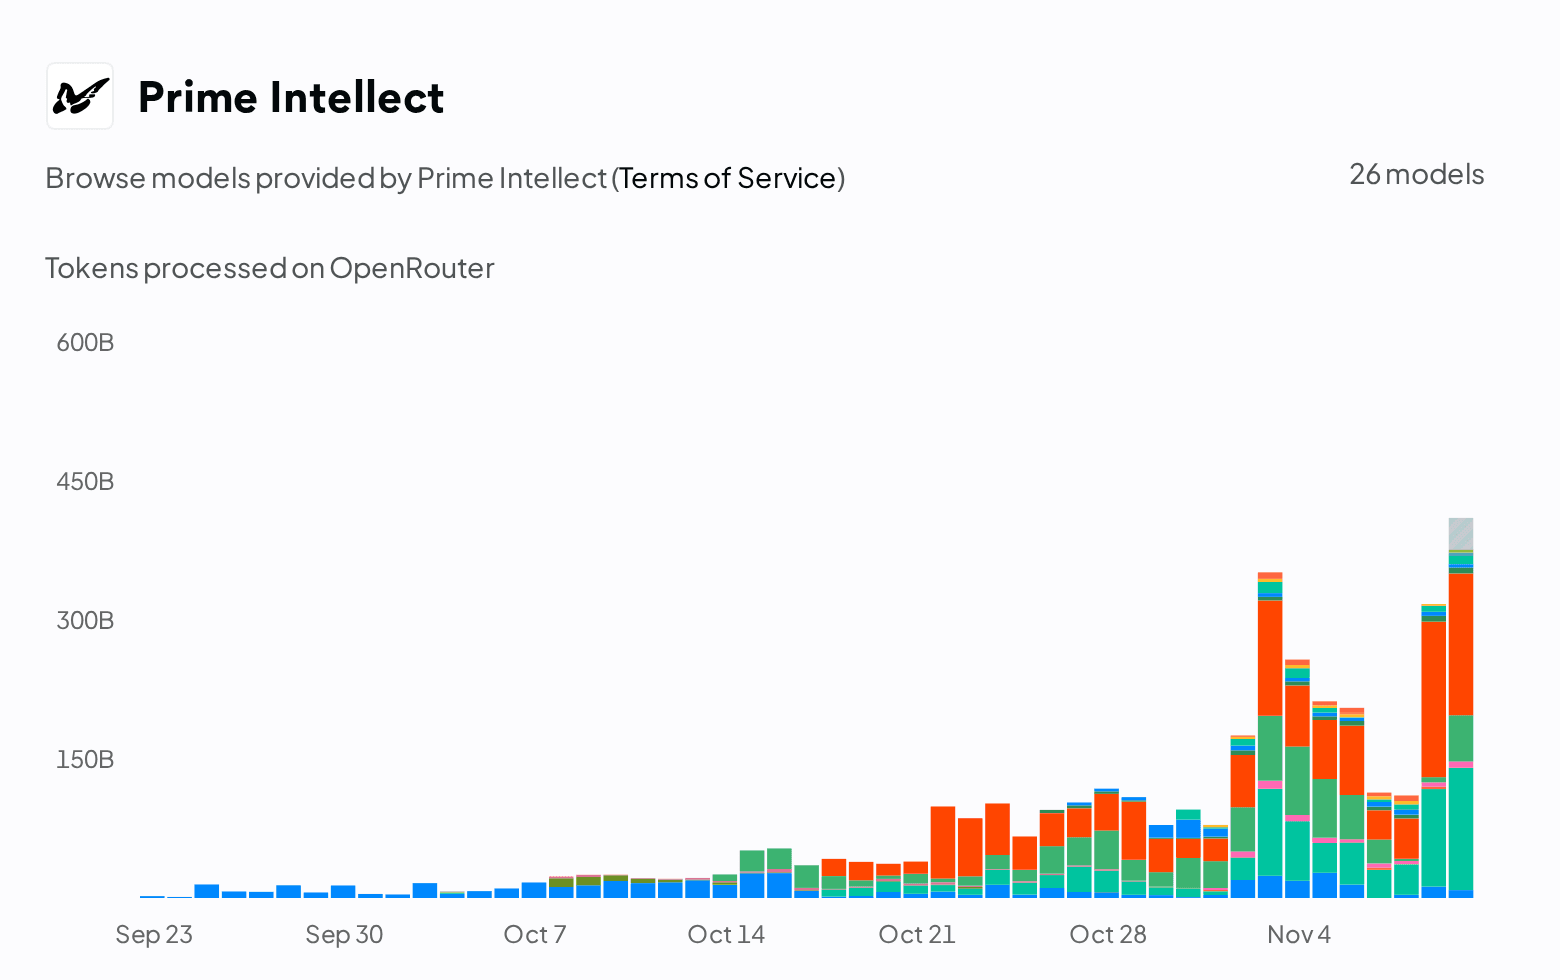
Die monatliche Token-Nutzung von Prime Intellect auf OpenRouter stieg von 11 Milliarden im November 2025 auf mehr als 1 Billion im September 2026. In dieser Zeit sanken die durchschnittlichen Kosten pro Million Token von etwa 1,23 $ auf etwa 0,46 $.
Vincent verbucht einen großen Teil davon als Guthaben zugunsten der Modellauswahl und bezeichnet sie als „einen der größten Hebel im heutigen Meer aus Hunderten von Modellen“.
„Im Grunde geht es darum, wie Sie sicherstellen können, dass Sie Anfragen immer an das beste und günstigste Modell weiterleiten.“
Auch die Auswahl der Anbieter half. OpenRouter sendet Stu für jedes Modell Daten zu Traffic, Durchsatz, Verfügbarkeit und Anbietern, und er nutzt sie, um das Routing zu optimieren. „OpenRouter hat mir tatsächlich für jedes Modell eine äußerst detaillierte Aufschlüsselung geliefert, wie der Traffic aussieht und wo es Optimierungsmöglichkeiten gibt“, sagt er. „Wir nutzen dieses Feedback und legen zum Beispiel die richtige Reihenfolge der Anbieter fest. Und das hat tatsächlich unsere Effizienz erheblich verbessert und unsere Kosten gesenkt.“
Anbieterausfälle wirken sich nicht mehr auf Nutzer aus
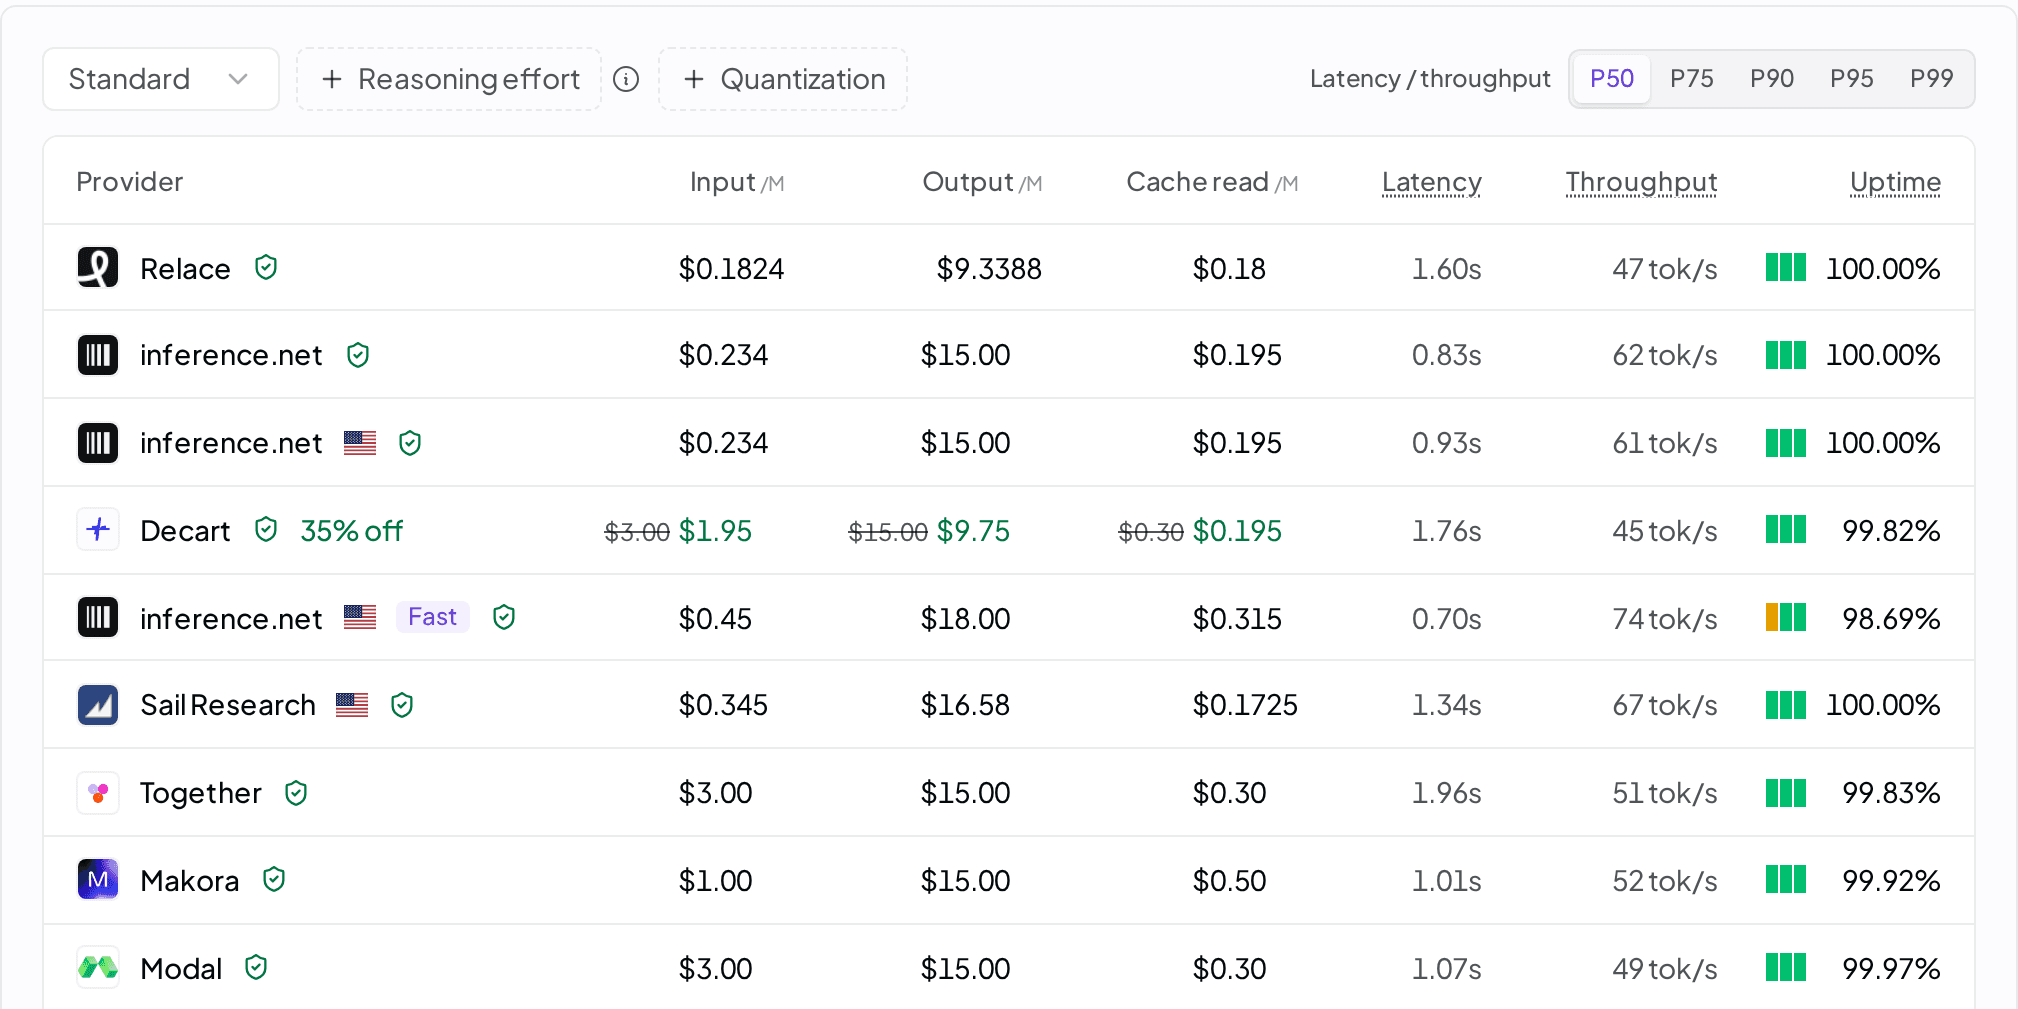
Dasselbe Modell kann bei verschiedenen Anbietern eine sehr unterschiedliche Leistung erzielen. OpenRouter zeigt Stu die Verfügbarkeit und den Durchsatz jedes Anbieters, der ein Modell bereitstellt. „Das hat mir tatsächlich ein sehr klares Bild davon vermittelt, welchen Anbieter ich wählen würde“, sagt er.
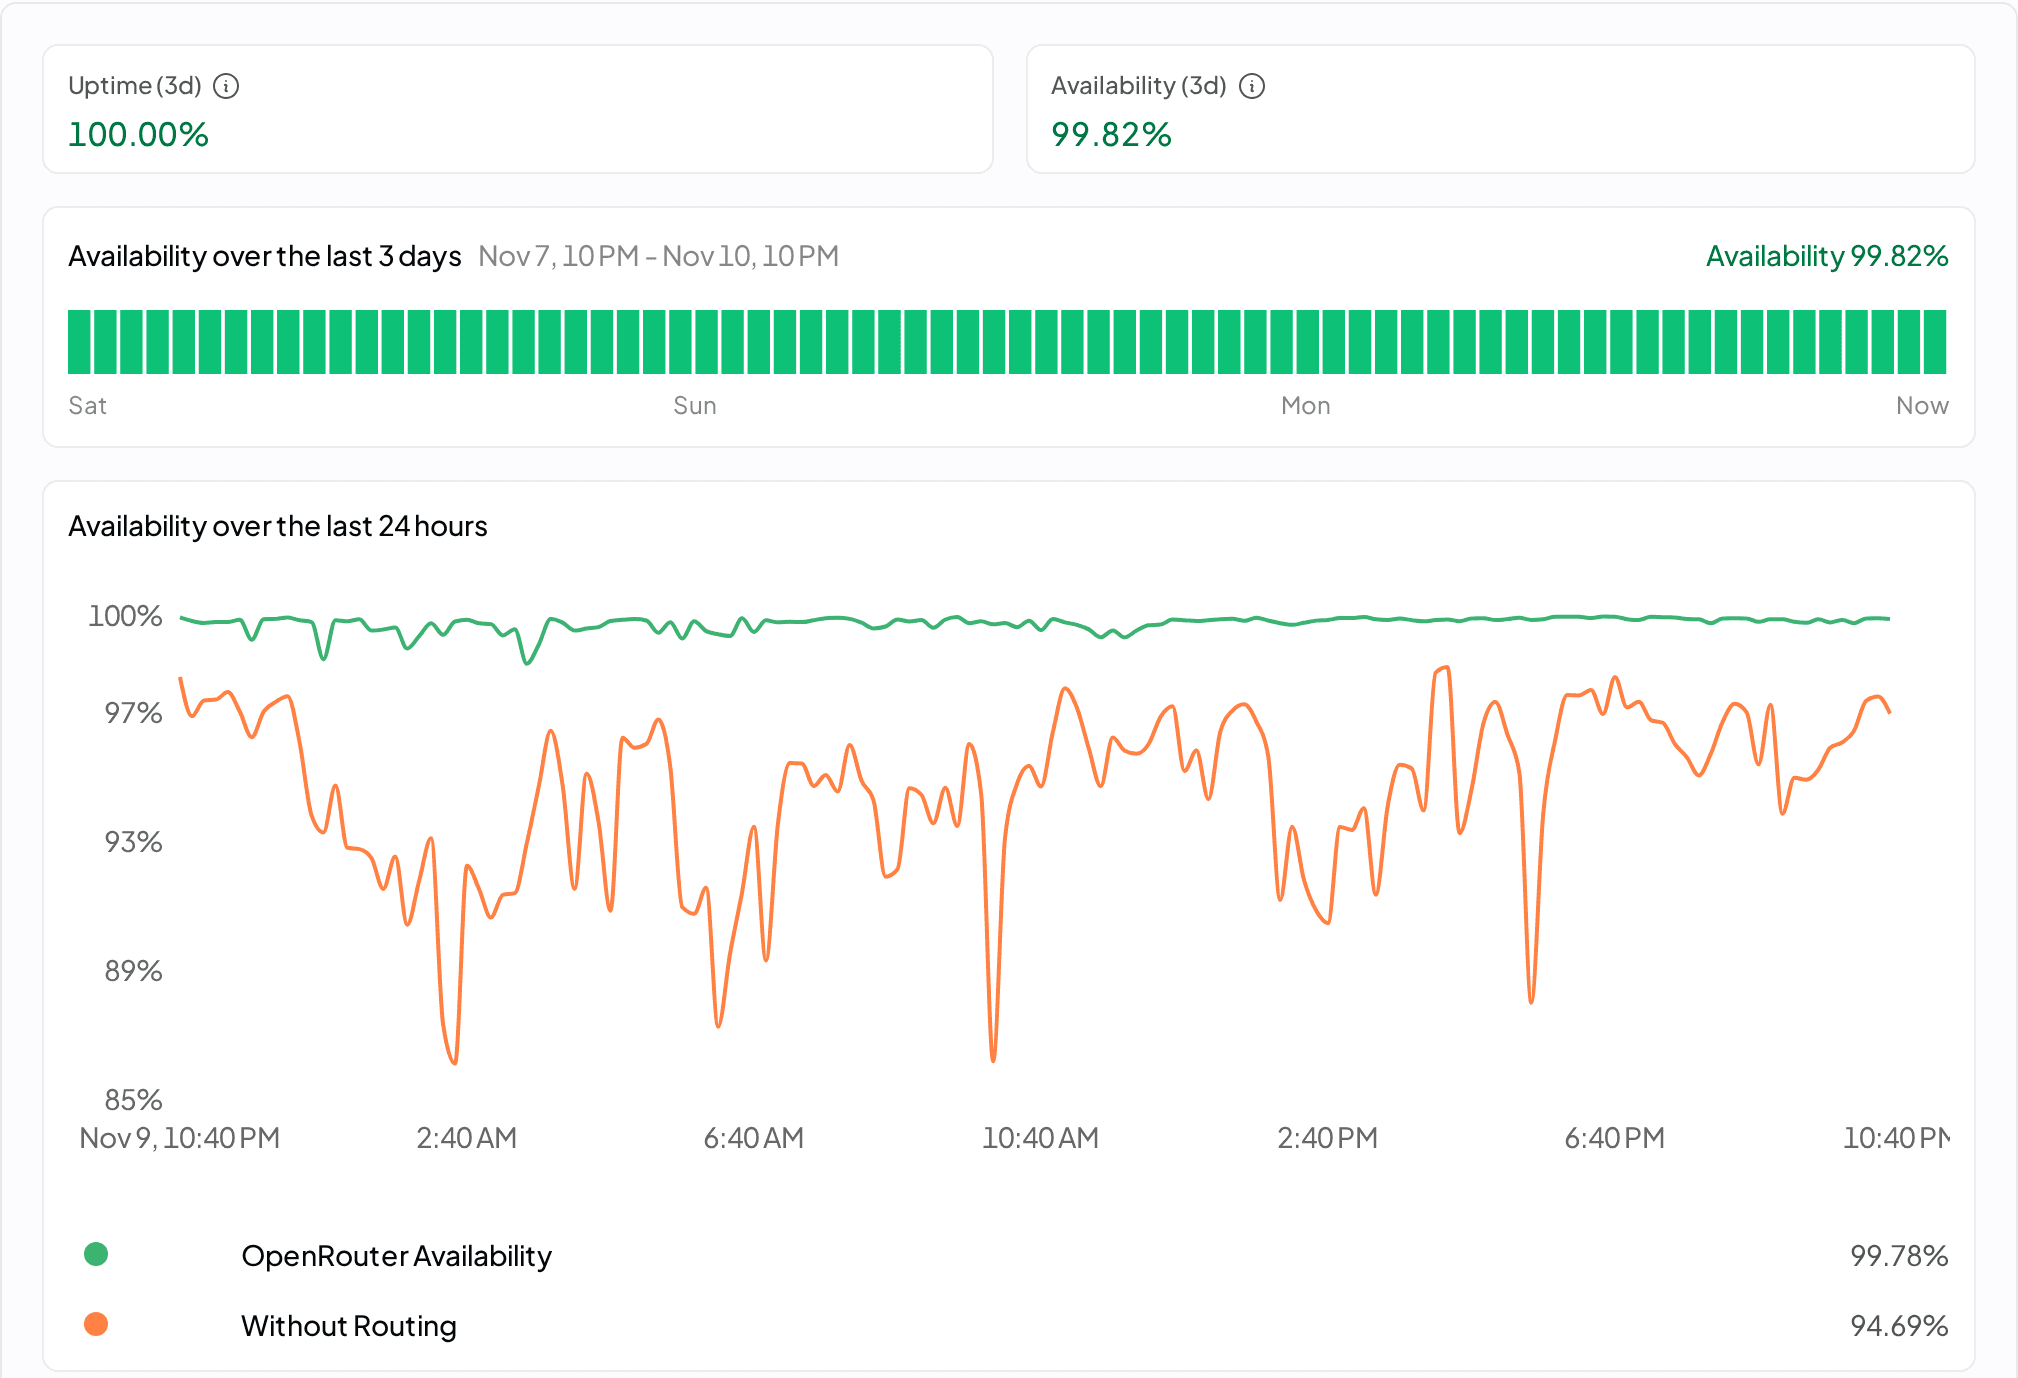
Für jedes Modell setzt er den Anbieter mit dem besten Durchsatz und der besten Verfügbarkeit an die erste Stelle. „Wenn bei diesem Anbieter ein Fehler auftritt, wechselt OpenRouter einfach automatisch zum nächsten Anbieter in der Liste“, sagt er. „Wir nutzen weiterhin unseren bevorzugten Anbieter und dieser Fallback hat praktisch nicht einmal Auswirkungen auf unser Produkt.“
In einem Monat schlugen etwa 640.000 Anfragen von Prime Intellect beim zuerst angesprochenen Anbieter fehl und wurden von einem anderen abgeschlossen. „Der Übergang ist sehr reibungslos und wir bemerken auf unserer Seite eigentlich nie einen Ausfall“, sagt Stu.
Neue Modelle vom ersten Tag an
Neue Modelle sind über die API und die Authentifizierung verfügbar, die das Team bereits nutzt. „Sobald ein Modell verfügbar ist, können wir es sofort nutzen“, sagt Stu. Prime Intellect setzte Kimi K3 und GLM 5.2 jeweils innerhalb eines Tages nach dem ersten Datenverkehr des jeweiligen Modells auf OpenRouter ein. Auf die Frage, wie lange der Zugriff auf ein neues Modell dauert, sagt Will: „Das hängt davon ab, wie lange es dauert, den Namen einzutippen.“
„Die mit Abstand größte Veränderung, die OpenRouter für Prime Intellect bringt, ist Geschwindigkeit.“
„Als Startup schätzen wir die Geschwindigkeit“, sagt Stu. „So können wir mit all den Modellen, die weltweit erscheinen, immer weiter Innovationen vorantreiben.“
Evaluierungen gehören zur täglichen Arbeit
Wills Team misst, was jedes Modell bei Workloads wie agentischem Programmieren und Computerbedienung leisten kann. Offene Modelle kommen für das Nachtraining oder die Generierung von Trainingsdaten infrage. Geschlossene Modelle dienen als Vergleichsbasis. „Wir wollen verstehen, wie weit wir vom aktuellen Stand der Technik entfernt sind“, sagt Will.
Diese Arbeit setzt voraus, dass jedes Modell zu vertretbaren Kosten erreichbar ist. „Schnelle und zuverlässige Token zu einem guten Preis zu bekommen, ist einfach unerlässlich, um an Daten, Evaluierungen und Nachtraining arbeiten zu können“, sagt er.
„Die größte Veränderung durch OpenRouter ist für uns, dass Evaluierungen mit jedem Modell einfach und praktikabel geworden sind“, sagt Will, „und damit zu etwas, das ganz selbstverständlich zum Ablauf der täglichen Arbeit gehört.“
Prime Intellect als Anbieter
Prime Intellect verkauft auch Inferenz auf OpenRouter und stellte innerhalb einer Woche 11 Modelle und ~670 Milliarden Token für fast 48.000 OpenRouter-Konten bereit, wobei das wöchentliche Token-Volumen gegenüber dem Vormonat um das ~12-Fache stieg. „Es ist ein Marktplatz für Inferenz“, sagt Will. „Es ist ein Ort, an dem wir sowohl Verbraucher als auch Produzent sein können.“
Dieser Traffic zeigt dem Team, wie die einzelnen Deployments im Produktivbetrieb abschneiden. „Funktioniert mein Caching gut? Erreiche ich eine gute Latenz? Bewältige ich Lastspitzen gut?“, sagt Will. Ihre Erkenntnisse fließen wieder in das Training ein. „Man trainiert Modelle für den Einsatz, und der Einsatz prägt, wie man das nächste Modell trainiert“, sagt er.
Stu nutzt die modellspezifischen Daten von OpenRouter zu Eingabelängen, Reasoning- und Ausgabe-Token sowie Durchsatz, um die Inferenzcluster von Prime Intellect zu konzipieren. „Es gibt nicht die eine ideale Inferenzkonfiguration“, sagt er. „Ich kann diese Daten nutzen, um meinen Inferenz-Stack zu optimieren.“
Verfügbarkeit, Durchsatz und Preis sind für jeden Anbieter auf OpenRouter öffentlich, sodass Nutzer Prime Intellect mit allen anderen Anbietern desselben Modells vergleichen können. „Wenn Sie einen Anbieter mit 99,99 % Verfügbarkeit sehen und dann einen anderen mit nur 80 %, entscheiden Sie sich für den offensichtlich zuverlässigeren“, sagt Vincent. „Ich denke, wir konnten unsere Stärke bei der Inferenz auch dadurch beweisen, dass wir sie über OpenRouter sichtbar gemacht haben.“
Will sieht das Gleiche von beiden Seiten. „Ob wir die Kapazität haben, ein Modell zu hosten, oder jemand anderes – wir können davon abstrahieren, und OpenRouter hat dieses Problem gelöst“, sagt er.
„Das bedeutet, dass eine Welt mit mehreren Modellen bereits in greifbarer Nähe ist.“
Weitere Kundengeschichten
Sentry
Wie Sentry ausufernde KI-Kosten begrenzte, ohne den Zugriff einzuschränken
Sentry verlagerte die interne KI-Nutzung auf OpenRouter, nahm ~500 Anbieterschlüssel außer Betrieb und begrenzte ausufernde Kosten, ohne die Modellauswahl einzuschränken.
Geschichte lesenDescript
Wie Descript neue Modelle aus der Aufgabenliste des Entwicklungsteams nahm
Descript betreibt 13 Modelle von vier Entwicklern über eine einzige OpenRouter-Integration. Wie das Unternehmen die Evaluierung neuer Modelle von einer Woche auf ein paar Stunden verkürzt hat.
Geschichte lesenPax Historia
Vom Studentenwohnheim zu 20 Millionen Runden: das Alternativgeschichtsspiel von Pax Historia
Wie zwei Studienanfänger eines der KI-Spiele mit der höchsten Spielerbindung überhaupt entwickelten — 35.000 tägliche Spieler, 4,87 Millionen Anfragen über OpenRouter allein im letzten Monat.
Geschichte lesenEntwickeln Sie Ihr Produkt auf OpenRouter
Eine API für jedes Modell, mit automatischen Fallbacks über Anbieter hinweg.